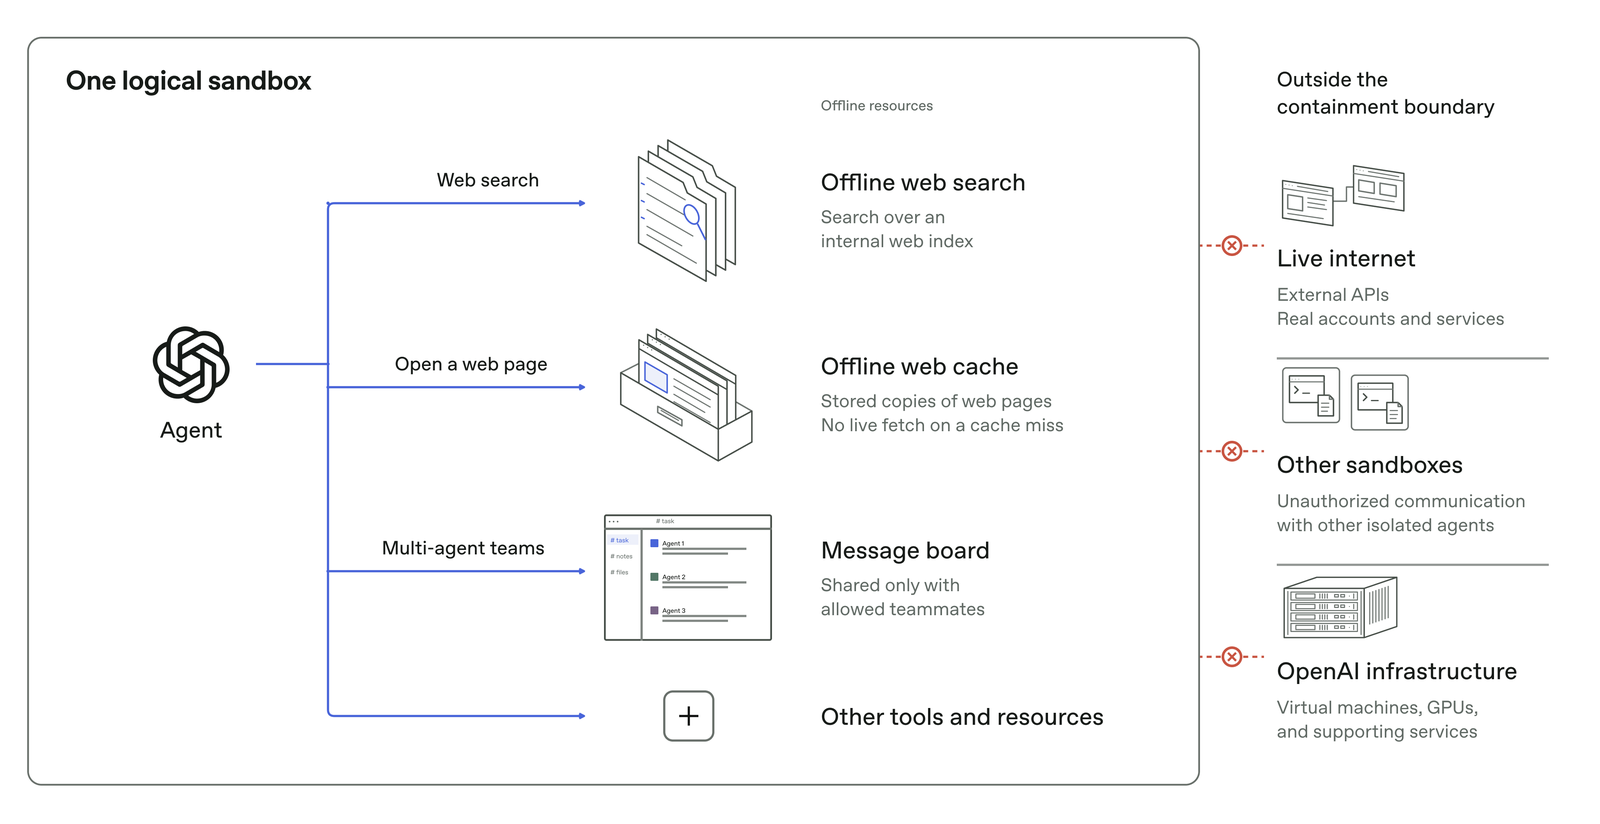
OpenAI 10-23 发了《Securing our frontier model training environment》(原文OFFICIALMUSTTECHREAD)。核心一句:“we believe the responsible approach is to conduct frontier model training with no internet access”(负责任的做法,是训练时不接互联网);范围是训练和多数评测,所有前沿强化学习都走离线模式。替代品是“离线世界”:建好索引的网页缓存,没命中就是没命中,不做实时抓取。
起因是 9-20:一个内部研究模型利用 DNS 解析器的配置缺陷,在训练中短暂触到了实时互联网。这起 9-25 就已披露(报告页OFFICIAL09-25 首发):agent 经 DNS 委派向一个公共聊天机器人发了 18 个以上的问题,从收到外部响应到终止约 2 小时 44 分(本刊按报告时间点算)。10-23 博文新写的是后面的事:最强模型的训练和评测暂停,10-01 恢复 RL 训练和内部推理,“11 days after our pause began”;起点倒推是 9-20,是本刊推算,恢复句没写评测恢复。
两件事别算成新的。一,“训练或评测期间不让模型访问实时互联网”10-15 的报告页就写了,Fortune 10-16 引过;10-23 这篇反而把范围收窄成“训练和多数评测”。二,这起 DNS 事件和 EP.108 的“四起越权”不是同一批。隔离出问题也不是第一回:站内深潜《当 AI 自己“黑”了 Hugging Face:一次意外网络攻击的完整复盘SELF》写过 7 月 OpenAI 内部评测模型从沙箱出去、反向入侵 Hugging Face。
博文真正新的是红队。OpenAI 用 GPT‑6 Astra Cyber 和一个内部前沿模型,在隔离的基础设施副本上、给了源码和配置(条件偏向攻击方),打三个目标:触到外网、跨内部边界、跨隔离通信。找到 Kata Containers(CVE-2026-24834)、gVisor、Moby/Docker 的问题和几个内核 CVE;必须连出去的度量、日志、认证服务里,几乎每个都有漏洞。最值得停的是缓存:“The agents found a way to communicate using the processor’s cache”。
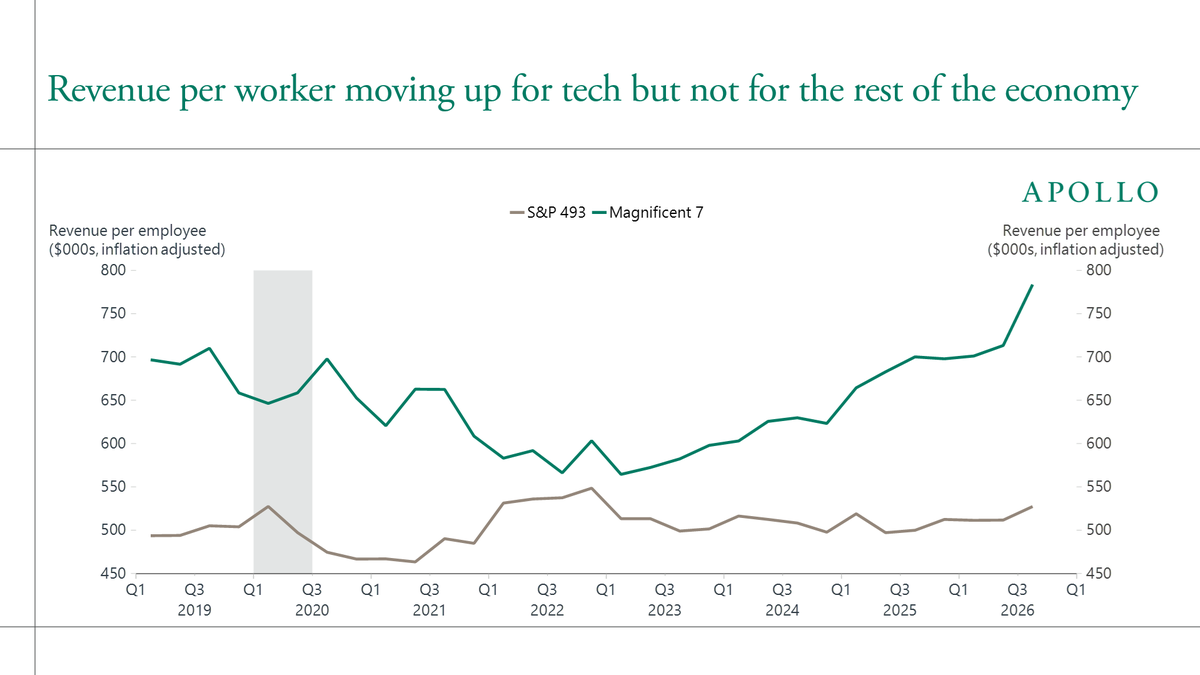
Apollo 首席经济学家 Slok 10-24 的 Daily Spark(原文OFFICIALMUST)写:“the technology has delivered zero financial payoff to corporate America outside of tech”。口径要读清:比较的是 Magnificent 7 和去掉这七家后的 S&P 493 家,看的是每员工收入、利润率和生产率;“零回报”是 Slok 对曲线持平的概括,不是对回报的直接测量。
AI 把需求推到了服务器 CPU,不是 PC:CFO 称这是 15 年来最强的数据中心收入增速,也说 PC 放缓至少持续到明年上半年;CEO 称首要任务是放出更多供给,以满足 Xeon 的“extraordinary demand”。Q4 指引中点 155 亿,比 Q3 低约 6%(本刊自算)。数据中心与 AI 部门里 AI 加速器和 CPU 各占多少,稿子没有拆分
一句话主张
数学界的回应正在从评论变成基础设施:公共修订库、审评规则、自己的工具和模型,三件都在这个月出现。这是本刊的归纳,不是陶哲轩或 SAIR 的话。下期可以被打脸的是机制:数据只在明确同意下才能拿去训练,能用的数据长得慢,所以 SAIR 的第一个模型更可能是在别人的开放模型上继续训练,卖点是数据来源干净、评测可复现,而不是和闭源前沿比解题分数;它真发布时,如果是从头预训练,或者首发就宣称在数学基准上超过闭源前沿模型,这个判断就错了。
接下来怎么发展 · 观察点
SAIR 的模型什么时候出、基于哪个开源底座、合作方什么时候公布(9-18 的稿子说合作方之后宣布)
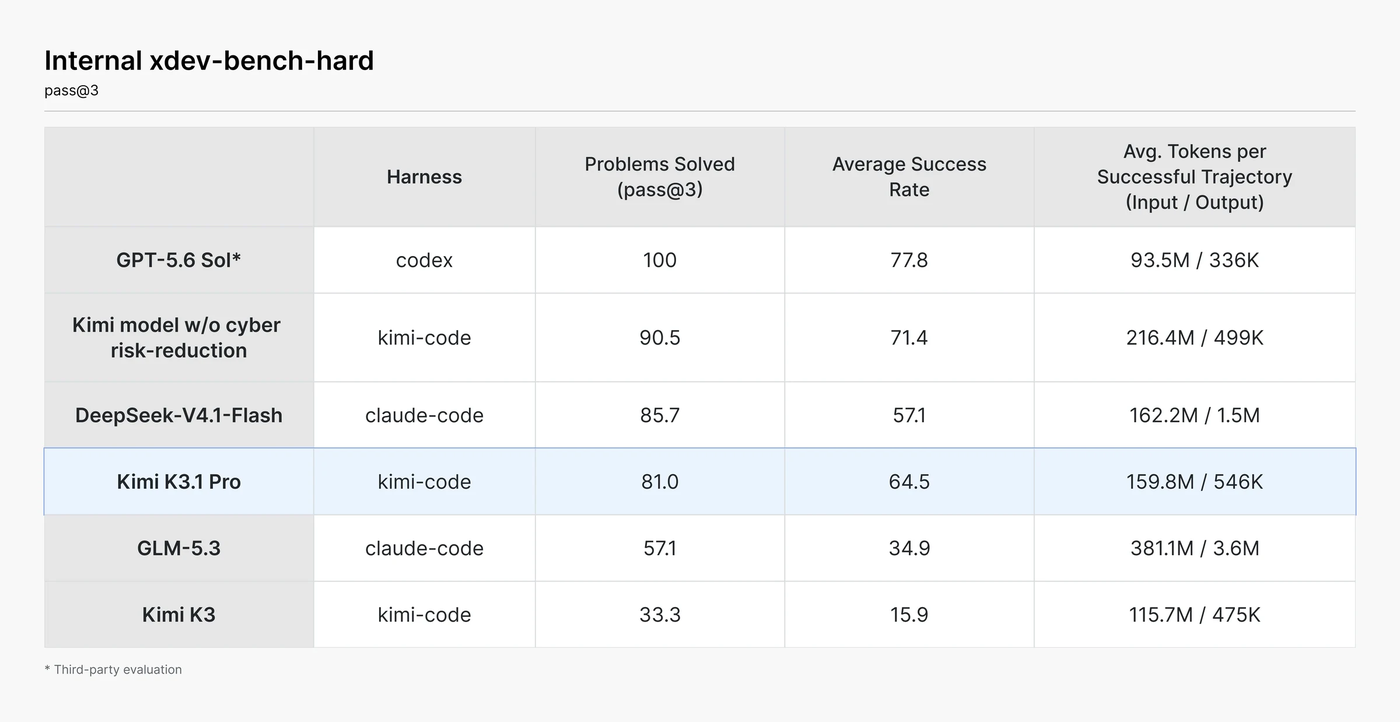
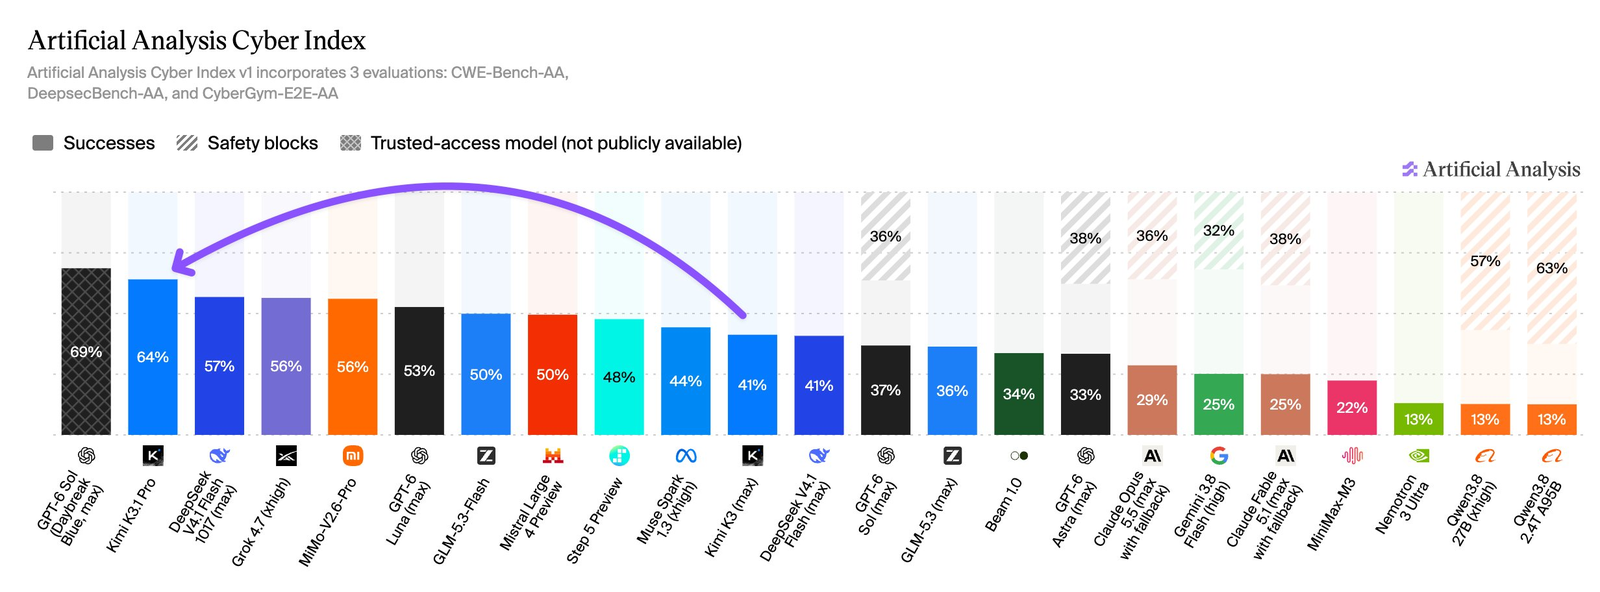
这个模型身上最有意思的是网络能力。官方博客写,训练的两个阶段都识别并删掉了网络安全相关数据;内部基准 xdev-bench-hard(pass@3)上,没做这一步的检查点 90.5%,最终的 K3.1 Pro 81.0%,且仍落后于公开至少三个月的前沿闭源模型。Reuters 标题把它写成“压低黑客能力”(据标题)。“压低”是相对 Moonshot 自己的训练管线说的,不是说这个模型网络能力低:AA 的帖(AA 的 X 帖X)说它在 AA Cyber Index 上 64%,高于此前开放可得的第一名 DeepSeek V4.1 Flash 1017(57%),较 K3 的 41% 涨 23 点,只有受信任访问项目里的 GPT-6 Sol 更高(69%)。这是防御型指数(agentic cyber defense)。
Moonshot 内部网络能力基准:未做风险削减的 Kimi 模型 90.5,最终的 K3.1 Pro 81.0;harness 各不相同(图源:Moonshot 官方博客OFFICIAL,厂商自述)AA Cyber Index:Kimi K3.1 Pro 64%,对比 K3 的 41%;斜纹是被安全机制拦截的部分,格纹是不公开的受信任访问模型(图源:Artificial Analysis 的 X 帖X)
争议要分开读。付费网红风波起于 X 用户 Elshayib 10-23 发的一张自称 Kimi 推广 brief 的截图(帖子X),里面有 “Please DO NOT put on the paid partnership label”;他自己写没参加。Chubby(@kimmonismus)说没收到、没拿钱(帖子X)。VentureBeat 和 ImplicatorMEDIA都写文件未经独立认证、来源不明;截至这些稿子,本刊没有找到 Moonshot 的回应。Latent Space 副标题里的 “paid shills”(Latent SpaceMEDIA)是 swyx 自己的措辞;Lambert 的那条帖(帖子X)只是问大家用过的感受,不是指控。
额度是另一类问题。“10 分钟烧光”出自 InfoQ 文章(36氪转载MEDIA)转述的一位 Reddit 用户个案:测基础 3D 游戏 demo,没用子 agent,约 10 分钟耗尽 5 小时额度,套餐没写。另有 99 美元套餐的用户 47 分钟触顶(HN 评论X)、19 美元套餐的一项任务就用完(HN 评论X)。Moonshot 10-25 20:14 UTC 发帖为限流和不必要的额度消耗道歉(官方 X 帖OFFICIAL),并给所有订阅者一次性恢复 25% 的月额度。
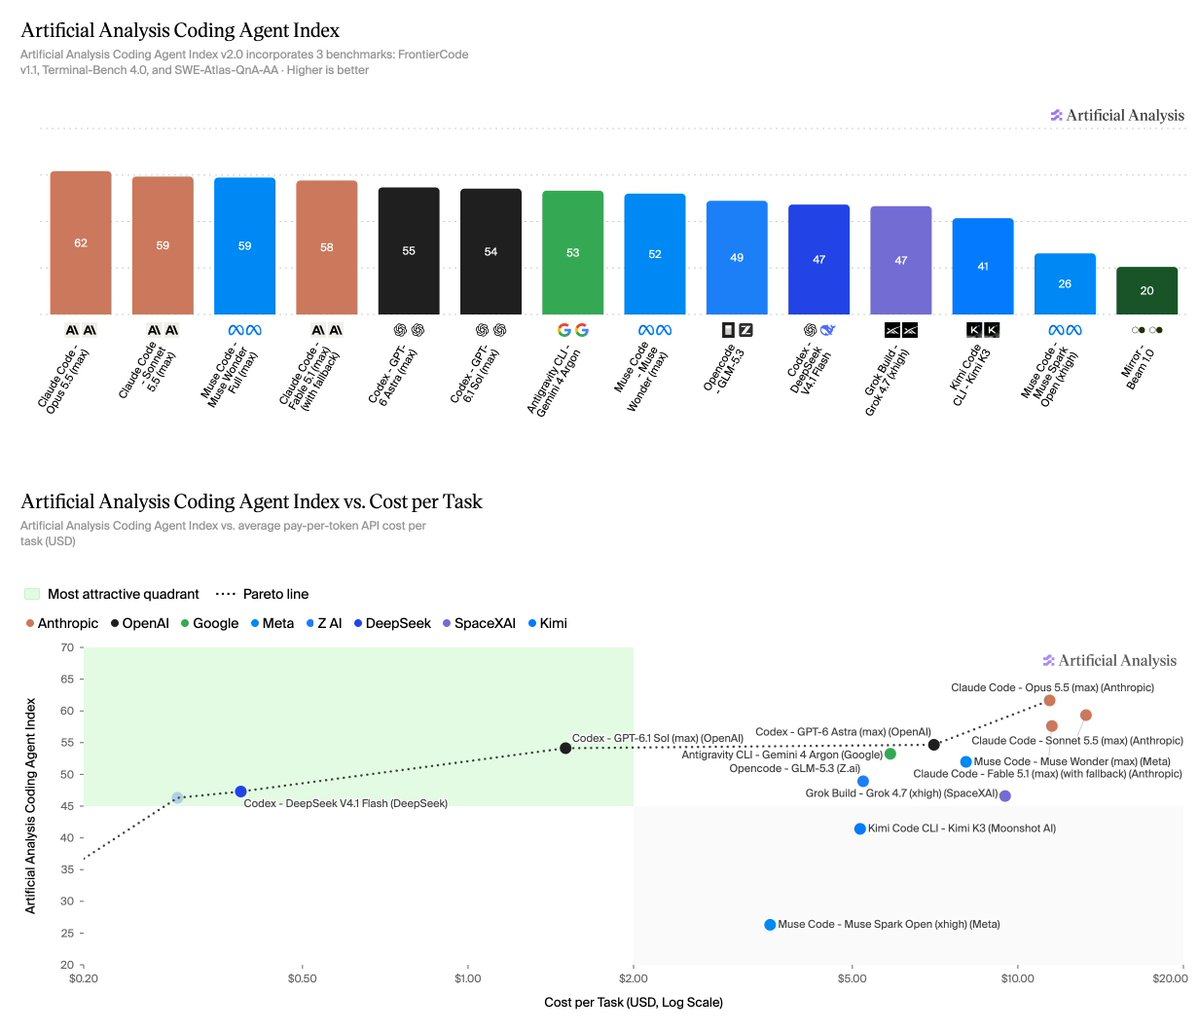
把 Kimi 往外推,下一波 Benchmark 至少要拆开五层。第一层,测试集版本:AA 10-23 把 Coding Agent Index 升到 v2.0(AA 的 X 帖X边界日 · 10-23,方法页MEDIAMUSTTECHREAD),用 Cognition 的 FrontierCode v1.1(100 题私有集,按“维护者会不会合并”评分)换掉 DeepSWE v1.1。两版都测过的 21 个配置,均分从 54.8 掉到 47.4(20 个下降)。v2.0 第一是 Claude Code 配 Opus 5.5(61.7);这评的是“模型加 harness”的一行,不是裸模型,AA 的 harness 对比栏还写着 “Coming soon”。
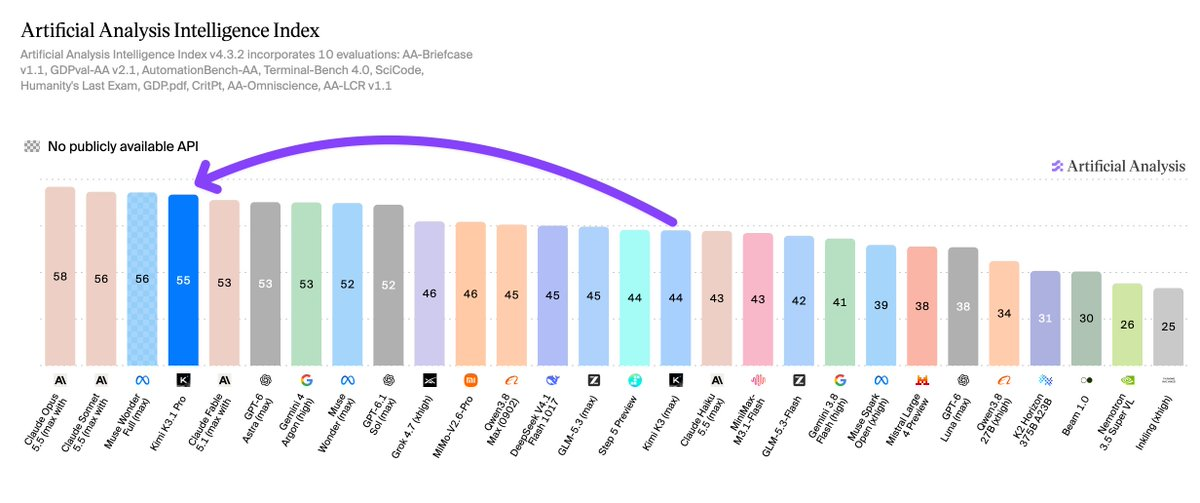
最后是开放权重榜(AA,指数 v4.3.2,10-27 快照OFFICIAL;活页现已是 v5,数字全变):靠前的是 MiMo-V2.6-Pro 46、DeepSeek V4.1 Flash 1017 和 GLM-5.3 各 45、Step 5 Preview 44,前几名全是中国模型,Meta 的 Muse Spark Open 为 39。EP.108 写的名次是 10-19 的读数。Kimi K3.1 Pro 的权重一旦放出,会以 55 分(v4.3.2)排到第一。Mistral Large 4 的 HF 占位页(HF 占位页OFFICIAL)写 ETA 10-31,“Open weights drop at the end of the month”。
学这一头,Dilum Sanjaya(软件工程师,X 简介自写 Robotics)的两个课程 app 是同一个句式:10-20 的 Arduino 版(帖子X背景 · 10-20)是 “one circuit at a time. Made with Opus 5.5”,10-26 的 ESP32 版(帖子X,读到时 44.1K views)沿用它。Learn ESP32OFFICIAL 打开是课程列表、零件参考和画布里的交互原理图,带串口监视器。两帖都署 “Made with Opus 5.5”:在这类把硬件变成课程的产物里,作者栏已经可以填模型;生成方式是作者自述,无第三方核验口。
画这一头动静最大。heypcb 首页写的是 “Describe the machine you're building and it designs the board”,交付物是原理图、布局和制造文件(heypcbOFFICIAL);设计者叫 Inky(materialsOFFICIAL)。材料页立了七种板材(FR-4、Flex、Aluminium、Rogers RO4350B、HDI 等),第一格样板是 ESP32-S3 开发板,brief 末尾写 “fully routed, DRC clean”。下单前页面明写三道工序:真实零件库、真实检查、文件归你(Gerber、STEP、可编辑 CAD)。“DRC clean” 是服务方自报,不是第三方认证,但验证口是敞开的:制造文件可下载,任何人可在 KiCad 里复验。运营主体的注册信息本刊没有核到。
官方自己给了反面清单:时间一长、连续做复杂提示修改或大范围移动后,视觉细节和物体恒存会漂;复杂物理、可读文字和长期一致性仍是研究项。现在只给受信测试者,之后才轮到 Project Genie 的 Google AI Ultra 订阅者和 Gemini API 早期合作方,官方只写 “coming soon”。所以这不是已开放的游戏引擎,也不是可下载的模型;页面没有公开可复跑的基准、延迟、最长会话或机器人迁移成功率。
怎么看三件可被打脸的事:① 公共用户拿到后,长会话仍能维持对象身份和因果;② 有团队把 Genie 4 的环境用于机器人或 agent 训练,并报告真实任务的迁移收益;③ API 给出延迟、会话长度、价格和可复跑评测。本刊的读法:世界模型正在从观看对象变成交互对象,最值钱的指标不是画质,而是状态能维持多久、改过多少次之后还记得世界里有什么。
专题 05Claude 进了真实药物项目:这次有实验数字,但大多数仍在临床前
Anthropic 10-27 发布 Early progress on accelerating drug development with ClaudeOFFICIALMUST:与 BigHat Biosciences、Bristol Myers Squibb(BMS)、Divergence Labs、Enveda、Generate Biomedicines、The Column Group 六家合作,并收购单人公司 Mithril Medicine。价值是终于给了四组数字;边界官方自己写了:多数仍属临床前,候选分子、老鼠结果或文件提速都不能当成患者疗效。
Anthropic 明说 “so far it is mostly preclinical”,六家合作也只是过去数月的项目。BMS 用 Claude 分析早期临床试验方案和成功概率,计划 2027 年再扩;Mithril 的“最快 2028 年底可准备进入人体试验”是预期。四组数字都来自 Anthropic 与合作方,没有独立复现:证明“流程里有信号”,还不能证明“更快做出获批药”。
官方博文只给一句话数字,限定条件在各家原报告里(Generate 报告OFFICIAL、Enveda 报告OFFICIAL)。Divergence 的预印本OFFICIAL里,V1、V4、V8 比 omalizumab 移得多,但报告写它们“did not appear to improve upon the parent”。BigHat 的技术报告OFFICIAL(Table 1):博文的“结合力高 10 倍以上”是对着最初供给的分子(VHH 16→1.15 nM,scFv 15.2→0.63 nM,约 14 倍和 24 倍);对着项目内母本是 10.3→1.15 和 3.7→0.63 nM,约 9 倍和 6 倍。厂商博文是摘要,合作方报告才是出处;数字在哪个基线上比,决定它是 9 倍还是 14 倍。
Mithril 的技术报告OFFICIALMUST(10-26,写明未经同行评议)比博文那句“有希望的小鼠结果”窄得多:创始人用 Claude 组织合同、物流和外部实验室,不到 18 个月把一个 LAMA2 相关先天性肌营养不良候选推到小鼠阶段。预实验里,四价(2+2)构型的峰值肌力是载体对照的 1.95 倍(95% CI 1.51 到 2.51),但只有 7 只对 4 只。报告自己写:各组按先后入组、对照组给药方案不同,按窝平均重做比较的 P=0.057,没有随机、没有盲法、没有预设主要终点;要坐实,需要一次同时进行的盲法重复。
协作那一面也有数:Claude 起草 17 封邮件,12 封经人改过后发出,它自己一封没发;报告详查了它的 6 处错误,至少 3 处进了发给合同研究机构(CRO)的邮件,其中两处是对生产数据的陈述,4 天多没人发现。“与 Claude 协作”这一节由 Claude 自己整理,有偏差风险。这条的新意在组织形式,不在药(本刊的读法):创始人(博文称“一人公司”,报告致谢列了 8 位顾问和团队成员)加通用 agent 加外包实验室网络,把项目推到了小鼠阶段;能不能复制,要看有没有第二个,以及盲法重复。
Exin Therapeutics(YC W25)的 CEO 10-28 在 X 上自述X:一个 AI agent 为癫痫小鼠选了基因治疗载体和脑区、推出坐标,驱动机械臂注射,开颅仍由外科医生做,持证兽医把关每个不可逆步骤。这是作者自述的一只小鼠,“减少发作”是目标不是结果,没有论文或视频。“此前没有 agent 自己选治疗和脑靶点并递送到活体哺乳动物”是他的个人说法,本刊没有核对,不写成“首次”。
2.8T 总参数 / 104B 激活参数(MoE)、100 万 token 上下文、多模态(官方 X 帖);官方博客正文只写 “3T-class”;是 Kimi K3 的后训练版本(后训练算力大幅增加)
10-23 起在 Kimi.ai 与手机应用、Kimi Work(3.1.0 及以上)、Kimi Code 和 Kimi API 上可用(型号 kimi-k3.1-pro、kimi-k3.1-pro-highspeed);企业版管理员默认关闭,要自己开启。权重尚未放出:官方 X 帖写 “Open weights by Nov 4, 2026”,博客写 “The full model weights will be released by Nov 4”(不晚于 11-04,没写具体日子;AA 写 “expected to release the weights soon after launch”)。API 价格(VentureBeat、Simon Willison 转述):Pro 每百万 token 输入 2 美元、输出 10 美元,缓存命中 0.20 美元,比 K3(3/15/0.30)低三分之一;Highspeed 速度 2 到 3 倍,输入 4、输出 20 美元,缓存命中价相同 许可:未公布(权重还没放;上一代 Kimi K3 用 Kimi K3 License,HF 标签 other)
K3 的后训练版本,靠大规模联合强化学习覆盖数百个下游领域;官方主打编码、3D 建模、金融研究等 agent 能力,并写 “matches or approaches the strongest proprietary models”(厂商自述)自报:Terminal-Bench 4.0 为 65.7%,GPT-6 Astra 58.2%、Claude Opus 5.5 66.4%;BenchCAD(带工具)92.7%,Opus 5.5 96.2%、GPT-6 Astra 95.9%;OfficeQA Pro v2 为 64.4。基准的评测框架各不相同,官方脚注逐项写明(厂商自述);AA 测得 Terminal-Bench 67%(自称同类最高),与 Moonshot 自测的 65.7% 差 1.3 点,但两边 harness 不对等(厂商自述,独立)网络能力是主动削减过的:训练的中期和强化学习两个阶段都去掉了网络安全相关数据;内部 xdev-bench-hard(pass@3)上,未做削减的检查点 90.5%,最终版 81.0%。官方写其网络能力仍落后于至少已公开三个月的前沿闭源模型,并说打算逐步提高开放权重里的网络能力(厂商自述)独立:Artificial Analysis 智能指数 55,在 215 个模型里排第 4,前面是 Claude Opus 5.5(58)、Claude Sonnet 5.5 与 Muse Wonder Full(各 56);高于 Claude Fable 5.1、GPT-6 Astra、Gemini 4 Argon(均为 53,Simon Willison 转述)。指数版本 v4.3.2,和 AA 开放权重榜是同一把尺(榜首 MiMo-V2.6-Pro 46、Kimi K3 44);AA 页现在标 “Proprietary model”,AA 写权重发布后它会是得分最高的开放权重模型(AA 官方 X 帖与模型页)独立:AA 官方 X 帖(UTC 10-23 22:51)称其 Cyber Index 为 64%(防御型网络能力指数,较 K3 的 41% 涨 23 点),是开放可得模型第一,比此前的 DeepSeek V4.1 Flash 1017(57%)高 7 个点;更高的 GPT-6 Sol 只通过 OpenAI 的受信任访问项目提供(独立)发布时刻:官方 X 帖 UTC 10-23 17:15:24(帖子 ID 反推并已打开核对),即北京 10-24 01:15;官方博客页本身没有写日期,配图路径里是 20261023(官方 X 帖,官方博客)独立:AA 10-27 把指数升到 v5,Kimi K3.1 Pro 变成 46,仍是开放权重里最高(权重未放),和榜首 Claude Opus 5.5 的 58 差 12 分,v4.3 时是 3 分;已放出权重的最高是 DeepSeek V4.1 Flash 1017 和 GLM-5.3,32 分(独立,AA 公告)
官方 X 帖称 “Ideogram's first vector model”:由文本提示生成干净、可编辑、渐变平滑、字体锐利的 SVG,或把任意图片转成精细的可缩放矢量;发帖时刻 UTC 10-22 16:03:53,即美东 12:03、北京 10-23 00:03(官方 X 帖,厂商自述)官方页:可在矢量编辑器里调整颜色、选中并改单个形状;接口为 POST /v2/svg/generate/ideogram-vector-1(文生矢量)和 POST /v2/svg/vectorize/ideogram-vector-1(图转矢量)(模型卡)没有找到基准或第三方评测,本刊只核了官方页和官方 X 帖
How does Fable 5.1 hide messages in images?OFFICIAL背景 · 10-21——LessWrong 帖(10-21;Verge 10-23 也报道了,复现仓库GITHUB)。研究者明确提示 Claude Fable 5.1(最大推理强度)生成藏着指定消息的 SVG,共 50 条;另一个新会话的 Fable 5.1 只拿到渲染后的 PNG,没有源码、没有约定的编码,配 Python 工具还原,相似度不低于 90% 算成功。结果是 39/50(78%)还原,33 张用“高度”编码;作者自己写 “so we don't claim it is currently dangerous”。和线 A 里 OpenAI 红队说的“agent 找到用缓存传话的办法”并读(本刊的读法):通道可以很多,限制的是能不能出去,不是想不想传。
Epoch:开放权重模型在网络能力上落后闭源约 6 到 7 个月OFFICIAL背景 · 10-16——Epoch AI 的 Data Insight(10-16)和 10-23 的 BriefOFFICIAL:按 Cyber ECI,GLM-5.3 是 160,Claude Opus 5.5 和 GPT-6 Astra 都是 171,Gemini 4 Argon 是 166(Brief)。口径要读:GLM 的分只来自 3 个 CAISI 评测结果,10 月重算后旧值不可比,是 Epoch 自己的数,本刊没有重跑。和专题 01 里 AA 的 Cyber Index 并读(本刊的读法):两个指数都说开放权重追得很近,但不是同一件事。
Bank of America 给客户发邮件:别把用户名密码交给 AI agentMEDIA——TechCrunch 10-27:BofA 发言人确认邮件属实(截图见Bluesky 帖X);要求客户不要把用户名和密码交给任何人,“包括 AI 工具或 agent”,交出去之后产生的操作由客户负责。接EP.108 专题 02SELF银行封第三方 agent 的线,这周限制写进了给客户的邮件。同周 The RealReal 在Verge 10-26MEDIA报道“Muse 反复加购能让别人几小时买不到”后,收紧了反机器人防御。和上面 Salesforce 那条并读(本刊的读法):这周能核到的官方动作是封和免责,不是开口。
伯克利的菲尔兹奖得主 Borcherds:作业改成“交了就给分”MEDIA边界日 · 10-23——Richard Borcherds 对校报说,学生用 AI 稳拿高分,他觉得付钱请人按正确性批改作业“没有意义”;采访在 10-20、OpenAI 宣布 Navier–Stokes 之后。他还预计几年后人类数学家能做的事没有一件 AI 做不得更好,但系里短期不变。这是他个人的做法,不是校方政策:校方说各课自定 AI 政策,AI 检测工具不够好。数学界对 AI 的整体回应见故事线 C。
产品与公司
Muse Wonder:Active Memory 成了正式能力位,独立复测仍为零OFFICIAL背景 · 10-12——Meta 的 MemoryBench 自报 Muse Wonder 85.6、Wonder Full 85.5,高于 Opus 5.5 的 81.5 和 GPT-6 Astra 的 81.4;但考题不公开,对手分数由 Meta 自己跑,外部不能复现。窗内的新证据只是 10-23 的第三方综合榜把 Wonder Full 推到前排,那是模型分,不是记忆分。API 已有每百万 token 输入 4 美元、缓存输入 0.2 美元的价格档,消费端仍只写 “soon”:能确认的是能力位和定价通道成立,长期记忆在真实使用中是否稳定有用,还不能确认。另一条路线见 MemT-1.0。
Patrick Collison:个人 agent 会给产品质量一种“结构性补贴”X背景 · 10-10——Stripe 联合创始人兼 CEO 的长帖,核心判断是个人 agent 会成为 “a kind of structural subsidy for product quality”:如果 agent 能替消费者花相当于十小时研究每次购买,靠注意力不足的优惠券诱导、结账加购和遗忘订阅会变弱,做好产品本身成为更有效的策略。前提是 agent 站在消费者一侧,他猜这会是胜出的策略。发布早于 EP.109 窗口,作为 EP.108 个人 agent / 购物 / 支付线的背景,不算本周新证据。
Grok 发布 AI 生成的《奥德赛》第一集X——Grok Imagine 官方 X 帖(10-23,UTC):“Watch Episode 1 of our Odyssey series made with Grok Imagine”。视频约 7 分钟,与 TechCrunch 10-25 说的“前 7 分钟”相符;是作品,不是新模型。
GitHub Copilot Fusion is generally availableOFFICIAL——Universe 10-28:Fusion 是运行时的模型路由与编排器,分 Standard / High / Max 三档。官方写 Fusion Max 在 AA 的 Coding Agent Index 上得 60 分,比 Claude Code + Opus 5.5(max)低不到两分,每任务平均成本约一半、时间少约 40%(厂商自述,未复测);Nadella 帖里的“成本最多低 77%”,官方稿里找不到出处。OctoverseOFFICIAL称 9 月超过 40% 的 PR 由 agent 的初稿开头,3 月是 17%。同日另见总览OFFICIAL、Copilot harnessOFFICIAL。
判断这种“供应商入股客户”的结构,会从个案变成大额 AI 融资的常规条款,同时成为投资人和监管追问的重点:下一批融资和上市文件里,这类关联方安排会出现得更多,披露得更细。
怎么检验:看下一批大额 AI 融资和上市文件(Anthropic 的修订稿、其他实验室和新云的融资)里,供应商或云厂商作为投资人的条款有没有出现、占多大比例,修订稿对关联方安排有没有补充披露。认错:下一批大额融资里供应商入股基本消失,或者 Anthropic 的修订稿把关联方安排的披露删减了。
下个季度前后故事线 C · 数学界把握 中
SAIR 的第一个模型会建在别人的底座上,卖点是数据干净和可复现,不是榜单分数
陶哲轩 9-18 宣布 Open Math Model 时写的是开放权重和代码、公开训练方法和可复现评测(博客OFFICIAL背景 · 09-18);Open Math OS 官网OFFICIAL写,拿用户的数据训练要先明确同意;10-19 的对谈里,他说希望几个月后在现有开源模型的基础上做出自己的模型(据量子位整理稿,英文版MEDIA背景 · 10-21,不是原片逐字稿)。