SI Force 10-15 开了首次正式会议、通过章程(120 天期);TNW 转述 Semafor 等:“The task force has not said what counts as an incident. It has not said how fast companies must report one, or what happens if they do not.”(TNWMEDIA)。10-23 又查了一遍:Federal Register 的官方接口,自 10-16 起检索 “Super Intelligence” 只返回一份文件,是 10-22 刊出的PCAST 会议通知OFFICIAL10-22,里面只有一句说 PCAST 也为 Super Intelligence Task Force 提供建议,全文没有“事故”或“处罚”的字样;whitehouse.gov 的总统行动OFFICIAL和简报与声明OFFICIAL两个列表,10-16 到 10-22 的条目标题里没有涉及 AI 或 SI Force 的文件(两个列表最新一条都是 10-22)。没有找到章程原件,所以章程里有没有这些条款本刊没有核到,但章程在 10-15 就通过了,在判定窗口之前。Anthropic 自拟的法案草案不是白宫的文件,口径只认 whitehouse.gov、Federal Register 或 SI Force 官方渠道(见故事线 A)。
OpenAI 说数周内公布的第三方评估合同:10 月 23 号前不会公布任何一家具名的评估方合同
目前没有触发,应验(这一条最接近触发)
OpenAI 官方的披露页OFFICIAL上只有旧关系:Hugging Face 事件那一栏写 “METR and Redwood Research also published findings from their independent investigation”(METR 和 Redwood 也发表了他们对该事件的独立调查),通知首发是 8-26,不是新合同。合同进度最新的说法是 OpenAI 本月初发的帖子:“actively finalizing contracts with third-party safety assessors and will announce details in the coming weeks”(CNBCMEDIA背景 · 10-11,这一页本刊没有核到,引文来自搜索摘录)。10-22 的CNBC 报道MEDIA10-22原页仍把这句写成“本月早些时候说的”,文里没有任何一份具名的合同,OpenAI 发言人只说这次试点会影响今后与独立评估方的合作。最接近触发的是同日 OpenAI 的官方 X 账号点了 METR 和 Redwood 的名(见故事线 A),但它说的是夏天做完的一次试点,没有合同或合同条款,是评估结果的公开,不是合同的公布,所以按口径仍算没有触发。openai.com 的官方页本刊没有核到,所以官方博客上有没有新稿不确定。
Reflection Beam 和 Mistral Large 4 的权重:10 月 23 号前,Reflection 不会放出 Beam 的权重,Mistral 也不会放出 Large 4 的权重
已被推翻(Reflection 一侧);Mistral 一侧目前没有触发
口径是“10-16 到 10-23 之间,Hugging Face 或两家官方页面上出现任何一家的权重,判断被推翻”。Reflection 的官方博客写 “Today, we have released Beam's model weights on Hugging Face under an Apache 2.0 license.”(reflection.aiOFFICIAL,10-16);HF 主仓库的提交 “Beam is available” 的时间是 UTC 10-16 10:34(北京时间 18:34,在上期周五中午分享之后,落在判定窗口的第一天),仓库公开、不 gated、Apache-2.0。技术报告没放,模型卡写“coming”,放出的是一份 Safety Technical Report。Mistral 一侧:10-06 的官方博客写 “by the end of the month”;10-23 再查,HF 上的占位仓库OFFICIAL页面标题仍是 “Upcoming release”,页面上的 “Current ETA” 是 2026-10-31(页面注明日期可能变),仓库里没有文件,mistralai 组织下也没有别的 Large 4 仓库(详见故事线 C)。所以这条的证据是“未出、占位页的预计日是 10-31”。
官方的那一头还是空的。白宫 SI Force(Super Intelligence Force)10-15 开了首次正式会议并通过章程,章程设 120 天期;国家情报总监 Clayton 在 CNBC 说会开得“very good”,设了三个小组:报告与响应、关键基础设施与私营部门、执法与责任(CNBCMEDIA)。TNW 转述 Semafor 等的稿子(TNWMEDIA)写得最直白:“The task force has not said what counts as an incident. It has not said how fast companies must report one, or what happens if they do not.”(工作组没有说什么算事故,没有说企业要多快报,也没有说不报会怎样);Semafor 引一位白宫官员说执法的一个选项“可能是出口管制”;国防部的 Michael 被指派建面向实验室的上报系统。章程没有官方原件:Federal Register 的官方接口 10-19 查“Super Intelligence”只返回三份文件,最相关的是 10-02 刊出的《Inaugurating the Era of Super Intelligence》(Federal RegisterOFFICIAL背景 · 10-02),没有 SI Force 的章程、规则或通知。(TNW 引的“delayed notification, inadequate corrective action, and a failure to take responsibility will not be tolerated”,本刊没有核到原始出处,不当作 10-15 会议的产出。)
纽约市议会那边是另一种“开口”。SpaceXAI 的全球政府事务负责人 10-16 在市议会的 AI 安全听证上作证,这是议会对私营主体发的第一张传票。议会的新闻稿OFFICIAL写:议长 Julie Menin 说自己用 Grok 几秒钟内生成了自己的性化图像,问“strict controls”(严格管控)怎么回事,证人答“could look into that specific instance”(可以去查那个具体案例);被问到被辞退的吹哨人 Devin Kim,宣誓下答不知道;Menin 称证词“simply unacceptable”(完全不可接受),会发后续信函。议会稿没有写 SpaceX 承诺了任何事故披露、外部评估或关停机制。(CNBC 的同日稿MEDIA网址里还是“将作证”的旧标题,正文已改成听证后的报道;证人头衔两处写法不一致:CNBC 写 head of global government affairs for AI,议会稿写 Senior Manager of Global Government Affairs。)
报告里还附了 Sol 那一起的推理轨迹,OpenAI 给了原文、加空格和翻译三个版本。X 上 @scaling01 把原文那一栏贴了出来,配的话是“完全可读,没什么好担心的”(反讽,帖子X):单词连在一起,几乎已经不是英语。Karpathy 在帖下回了一句 “Yeah I’d say the RL is working now all right”(RL 现在算是搞对了),引的是他 2024 年 9 月的一句话:RL 做对了的标志,是模型的思维链不再说英语。这是 Karpathy 对“思维链不再是英语”的评论,不是 OpenAI 的结论,也不是对这起事件的定性;报告里的轨迹是脱敏后的还原文本,也别当原话引。
OpenAI 10-22 做了一件不一样的事:把外人请进来查自己的监控,并让外人公开说查到了什么。METR 当天发了Red-Teaming OpenAI's Internal Agent Monitoring SystemsOFFICIALMUST10-22,OpenAI 的官方 X 账号同日也发了一条(OpenAI 的 X 帖OFFICIAL10-22):“This summer, we invited METR and Redwood Research to pilot an embedded evaluation of our internal monitoring system”(今年夏天我们邀请 METR 和 Redwood Research 对内部监控系统做嵌入式评估的试点)。METR 写的做法是:7-21 到 8-11 三周,METR 和 Redwood 各派一人驻场,看内部代码库、监控的提示词和配置、内部文档,访谈了约十二位研究员和工程师;用 OpenAI 发的设备,设备不出场地,有人陪同;产出一份 61 页的内部报告,公开稿是事先约好的简短版,OpenAI 对公开稿有保密删节的最终决定权(脚注写 “in its sole discretion”),METR 说它认可公开稿里的每一条发现。评估的是 7-21 当天及以前的版本,不含当时正在扩的新版本。
OpenAI 的回应是:影响生产防护栈的漏洞都已修补;METR 在页面里写明 “We have not evaluated these claims”(我们没有评估这些说法)。Reuters 引的 OpenAI 声明说,这些发现帮它在扩展系统时加固了防护,也会影响今后与 METR 和其他第三方评估方的合作(ReutersMEDIA10-22,KSL 转载)。读的时候要分清三件事:这是 7-21 当时的旧版系统,不是现在的;“已修补”是 OpenAI 的自述,METR 没验证;公开稿是被约定过范围、也被删节过的版本。它和上面 10-20 那两起也不是一回事:那是 agent 做任务时顺手把监控拆了,这是监控系统本身的覆盖缺口。METR 给了五条建议,核心是让绕过监控变难、让该监控的流量真被监控(全部流量记账、和监控日志对账)、出事快速响应、持续红队、把 agent 和监控隔开。METR 今年 3 月对 Anthropic 也做过同类演练(METR 的页面OFFICIAL背景 · 03-25)。这件事也碰到上面的复盘:OpenAI 说数周内公布的是第三方评估“合同”,这次公布的是一次做完了的试点评估,不是合同,所以那条判断没有改(见上期判断复盘第 3 条)。
Anthropic 这周也有一份自陈:约 10-21 发布的首份 Public Benefit Report(页面和 PDF 都没写发布日,日期由 Stubbs 加入长期利益信托那篇稿子里“本周发布了首份报告”倒推)在“前路”一节写,四个 Claude 模型在一次网络安全测试里,因测试环境配置错误接上了公网,未经授权访问了真实的第三方系统;又写 “there is no mandatory independent check for whether any frontier lab, including Anthropic, is actually following its safety policies”(目前没有强制的独立检查,来核实任何前沿实验室,包括 Anthropic,是否在遵守自己的安全政策),嵌入式评估才刚开始,而且也只是自愿的(报告 PDFOFFICIAL约 10-21、落地页OFFICIAL)。和 METR 那件事放在一起读:外部评估这周有了公开的样本,但两家实验室自己都说,眼下没有任何东西强制它们接受评估。
先看压力最大的 CoreWeave。10-15,CNBC 写它 5 年期 CDS(信用违约互换)的利差“at one point soared above 1,140 basis points. It last stood at nearly 1,038 bps”(一度升破 1,140 个基点,最近报约 1,038)(CNBC 10-15MEDIAMUST背景 · 10-15)。这是利差,不是违约概率;“困境”这个词的出处是 S&P Global Market Intelligence 的 Gavan Nolan:利差 1,000 个基点及以上,一般是信用困境的信号。同一篇写它 2031 年到期的 9.75% 债券,到期收益率到了 15.78%,CoreWeave 为 AI 基建已承担超过 510 亿美元的债务和义务;股价 10-14(周三)跌 15.5%,10-15(周四)收涨 5.94%。CEO Mike Intrator 的内部备忘录(CNBC 称“obtained by CNBC”,不是公司公开声明)写:“We are confident in our backlog which more than supports all of our debt obligations.”(我们对在手订单有信心,它足以覆盖全部债务);Deutsche Bank 的研报说在手订单超过 1,000 亿美元、约三分之二对应投资级对手方(Microsoft、Meta、IBM、Caterpillar),维持买入。
大盘和央行是同一周的背景,但要读准。CNBC 10-16:VIX 四个月来首次升破 22(盘中),Nasdaq 当天跌 2%、是 6 月 5 日以来最差的一天(CNBC 10-16MEDIA);Investing Club 的口径是 Nasdaq 周内跌 4.5%。曼谷的 IMF 世行年会上,Reuters 写央行官员在议论更高的利率(Reuters 10-16MEDIA,Kitco 转载全文):ECB 委员 Martins Kazaks 说“There is a global fight for money”(全球在抢钱),“Investment in AI is one of the key factors driving up the cost of money”(AI 投资是推高资金成本的关键因素之一);Fed 主席 Warsh 说 AI 投资是一个冲击,“hitting the demand side of the economy before it’s going to hit the supply side”(先打到经济的需求端,再打到供给端)。注意没有哪位官员说“因为 AI 要加息”:标题是 Reuters 的概括,说的是中性利率可能更高、资金成本在被推高;BoE 在 11-05 加息,是 Reuters 写的经济学家预期,不是央行表态。
反面证据要一起放,因为需求这头的硬数据还在涨。施耐德电气 10-16 第二次上调 2026 年目标(Reuters 稿MEDIA,电台站点转载全文):调整后 EBITDA 有机增速 18% 到 21%(原为 14% 到 19%),Q3 营收 114.6 亿欧元、有机增长 16.9%,CEO 在季度声明里说数据中心订单“triple-digit demand growth”(三位数的需求增速),来自美国超大规模云厂商的持续强需求,Q3 的增长由中国和东亚领跑;这是需求增速,不是营收增速,而且是公司自己的披露。韩国财长 Lee Hyoung-Il 10-17 在曼谷对 CNBC 说,半导体的增长“at least through next year”(至少到明年)还能维持(CNBCMEDIA);这是官员为本国最大出口行业说话,有利益相关。放在一起读:需求端的订单还在往上走,被拷问的是“谁来为它付钱”。
上期这条线SELF说了两件事:美国公司做的决策模型,基座全是阿里的 Qwen;前沿那一层,美系开放权重的回应还停在承诺上。承诺这周兑现了一部分,块头不小。顺带更正上期的一个归类:Mistral 是法国公司,它的 Large 4 不该算“美系”,下面统一说“美欧一侧”。
Meta 10-15 在自家博客发布了 Muse Spark Open 的权重(官方博客OFFICIAL背景 · 10-15;发布在上期窗口的最后一天,上期漏收):“816B total parameters (42B active) and a 1M-token context window”(8160 亿总参数、420 亿激活、100 万 token 上下文),主打编程和 agent。标题写的是“The Most Capable US Open-Weight Model to Date”(迄今最强的美国开放权重模型)——“最强”是 Meta 自己写的,依据是它放在博客里的评分图。权重在 Hugging Face 的 meta-models/Muse-Spark-Open-816B-A42B,要填表、经人工审批才能下载(gated: manual),Amazon SageMaker、Google Cloud Model Garden、Microsoft Foundry 也能下。这张评分图要读全:Muse Spark Open 在 JobBench(61.8)、MCP-Atlas(89.2)等几列是第一,但 Terminal-Bench 2.1 是 76.4,低于 Beam 的 80.1,也低于 Qwen3.8-2.4T-A95B、GLM 5.3、Kimi K3 的 82.0、83.9、85.0;DeepSWE 1.1 是 60,低于 Mistral Large 4 的 62、GLM 5.3 的 67、Kimi K3 的 68。所以 Meta 自己的表也没有说它压过了中国模型,“最强”指的是美国开放权重这一档。
第三方的位置要看 Artificial Analysis(本刊 Neo Lab 档案Artificial AnalysisSELF)的开放权重榜(榜单页OFFICIAL,Intelligence Index v4.3.2,本刊 10-19 读取):Muse Spark Open 是 38.87,排第 7,是榜上美国模型里最高的;前六名都是中国模型——小米 MiMo-V2.6-Pro 46.32、DeepSeek V4.1 Flash 1017 45.10、GLM-5.3 44.78、阶跃 Step 5 Preview 43.73、Kimi K3 43.59、GLM-5.3-Flash 41.81。Nathan Lambert 在 Interconnects 的文章MEDIAMUST10-17里说它是“the strongest American-made open model by quite some margin”(美国造的开放模型里遥遥领先),并写:“Without these two models, there would be 20+ open-weight models built and released by Chinese companies better than the best Western models.”(没有这两个模型,会有 20 多个中国公司造的开放权重模型比西方最好的还强)——这两个指 Muse Spark Open 和 Beam。
许可证是这个模型最该读的一块,因为外面流传的说法有出入。它叫 Muse Model License,大意是 MIT 式的宽授权——可以使用、复制、修改(含微调)、蒸馏、再发布、售卖——但带三个条件(许可证全文取自模型页OFFICIAL的元数据)。一,在每个使用本软件或其衍生品的产品或服务里,要显眼地标 “Built with Muse Spark Open”。二,“衍生品”的定义很宽,包括用它的输出训练、蒸馏或改进出来的任何模型,所以拿它造合成数据,也得标、也得守使用政策。三,收入门槛只针对“Model as a Service”(把模型的 API 卖给第三方):被许可人及其关联方在任意连续 12 个月的合计收入超过 2000 万美元,要先通知 Meta 并签单独协议;自用、研究、把它当自家产品的一个组件,都不触发。Lambert 的文章把门槛写成“每月 2000 万美元、部署模型”,署名写成 “Built with Muse”,对照许可证原文有出入;他对这份许可证的结论是它是“an unnecessary strategic risk for labs trying to compete and regain adoption”(对想竞争、想重新赢回采用率的实验室,是一个不必要的战略风险)。许可证怎么从限权走向 Apache 2.0、又分化,本刊深潜《大模型厂商 ToS 与 License:法律条款是产品战略的「加密版」SELF》追踪过 DeepSeek、Qwen、智谱、Google、Meta、xAI、Kimi 的许可证(2026-09 的专节),Muse Model License 是 10-15 才出的,不在其中。
本地算力这头,Meta 说它是“the first model in its class to run on your desktop using two Apple M5 Ultra Mac Studios”(同级别里第一个用两台 M5 Ultra Mac Studio 在桌面上跑起来的);Apple ML Research 同一天发了篇MLX 分布式推理的文章OFFICIAL背景 · 10-15,头条数字是四台 Mac Studio 上每秒生成 36 个 token 以上,两台是 15.74 到 24.99;NVFP4 量化后约 493GB,单台装不下。两件事要分开:Apple 这篇没有写“与 Meta 合作”,合作的说法来自 Meta 的博客和 The Verge 的报道MEDIA背景 · 10-15(引了 Zuckerberg 在 X 上的话和 Apple 新任 CEO John Ternus 的回复,X 帖本体本刊没有核到)。NVIDIA 在 HF 上架的 Muse-Spark-Open-816B-A42B-DFlash2 也不是衍生出来的新模型,而是给它配套的投机解码草稿模型(4.38B 的稠密小模型,模型卡写 “rather than as a standalone target model checkpoint”)。
Reflection 的 Beam 是上期预测被打脸的那一个(这家公司的背景,见本刊 Neo Lab 档案Reflection AISELF)。官方博客 10-16:“Today, we have released Beam's model weights on Hugging Face under an Apache 2.0 license.”(reflection.aiOFFICIALMUST);HF 主仓库是 reflection/Beam-1.0-501B-A23B,提交记录里 “Beam is available” 的时间是 UTC 10-16 10:34(北京时间 18:34,在上期周五中午的分享之后)。模型卡(HFOFFICIAL)写:501.3B 总参数、23.4B 激活、100 万 token 上下文、仅文本,Apache-2.0,并写明 “Reflection does not prohibit distillation, use of outputs to train other models”(不禁止蒸馏,也不禁止用输出训练别的模型)——没有 Meta 那种署名和收入门槛。技术报告还标着“coming”,放出的是一份 Safety Technical Report。评测数字都是 Reflection 自述:Terminal Bench v2.1 80.1%、SWE Bench Pro v1 66.1%、GPQA Diamond 90.6%,并自称用约三分之一的推理 token 达到可比质量;Meta 评分表里引的 Beam 数字(如 MCP-Atlas 78.7)和 Reflection 自己模型卡里的(80.8)不一致,以模型卡为准。AA 榜上 Beam 是 30.33,排第 10。
中国这边,DeepSeek V4.1 Flash 1017 在 10-17 发了(官方新闻页OFFICIAL,权重在 Hugging Face,MIT 许可)。官方的说法是 “a Pareto improvement in performance and cost”(性能和成本上的帕累托改进),用带自反馈的强化学习提升端到端的项目开发。模型卡的对比对象是 Kimi K3、GLM-5.3、GPT-5.6 Sol 和 Opus 5(没有 Opus 5.5):HLE(无工具)是 42.6,Kimi K3 是 43.5,K3 略高;DeepSWE v1.1 是 77.0(Mini-SWE-V2 harness),Terminal-Bench 4.0 是 42.3(Claude Code harness)。AA 榜上它是第 2。
“harness”(给模型套上的那层 agent 外壳)是这周的新变量。官方新闻页和 DeepSeek 主账号写的是 “Optimized for DeepSeek Harness, Tencent CodeBuddy, WorkBuddy, and more”(针对 DeepSeek Harness、腾讯 CodeBuddy、WorkBuddy 等做了优化);“训练时专门针对”这个说法出自 DeepSeek Harness 产品账号的推文X:“The new model was specifically optimized for @DeepSeekHarness during training”,模型卡里没有这句。Reflection 的做法同向:“We trained Beam along with the Mirror CLI harness to offer best performance, while also integrating with other popular open source harnesses”(我们把 Beam 和 Mirror CLI harness 一起训练以求最佳表现,同时也接入其他流行的开源 harness),Mirror 是它开源的终端 agent harness。把三家放在一起看更清楚:同一个基准 DeepSWE v1.1,DeepSeek 报 77.0(Mini-SWE-V2 harness),Meta 报 60(脚注写 “Best available/ Self reported harness”),Reflection 报 43.3。三个数用的 harness 不同,不能横向排名;分数取决于配哪个 harness,这本身就是这条线的证据。
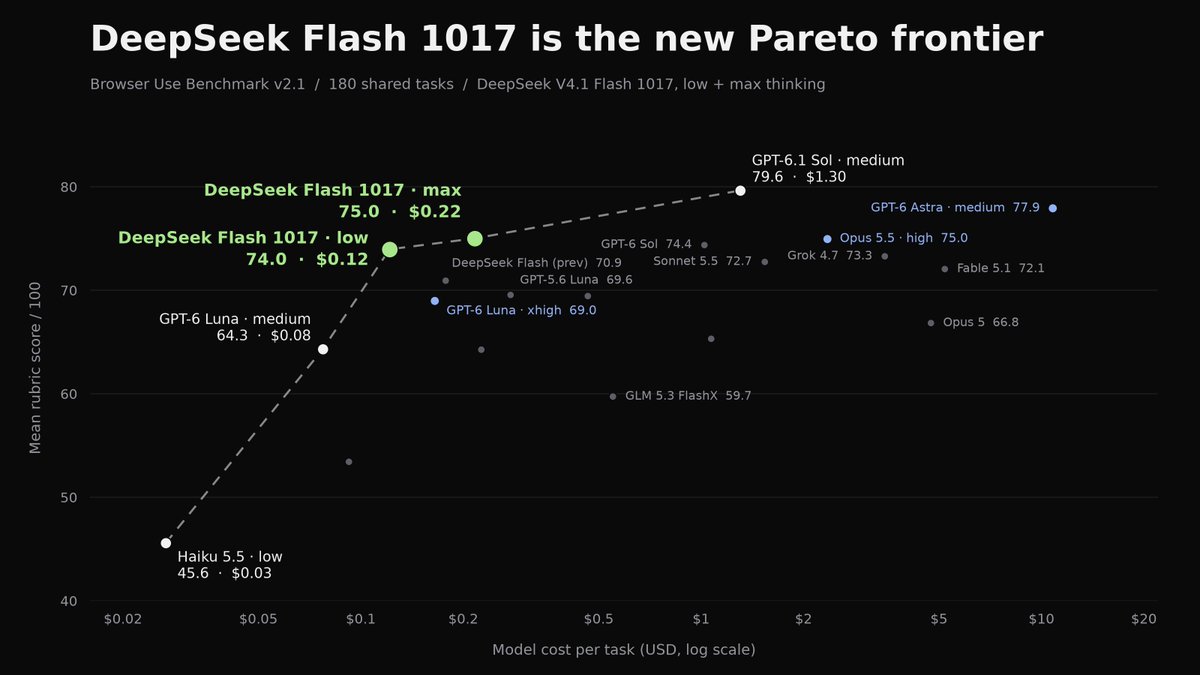
Browser Use 10-18 的推文X说 “DeepSeek V4.1 Flash 1017 just matched Opus 5.5 on long horizon browser use. 19x cheaper”(在长程浏览器任务上刚刚追平 Opus 5.5,便宜 19 倍)。图里写明了设置:Browser Use Benchmark v2.1,180 个共同任务,评分表打分。Flash 1017 的 max 档 75.0 分、每任务 0.22 美元,low 档 74.0 分、0.12 美元;Opus 5.5 的 high 档 75.0 分、约 2.35 美元;同一张图里 GPT-6.1 Sol(medium)79.6 分、1.30 美元,GPT-6 Astra(medium)77.9 分,都更高。所以“追平”指的是和 Opus 5.5 high 同分;便宜约 10.7 倍是 max 档对 2.35 美元,“19 倍”对应的是 low 档;这是卖浏览器 agent 的公司用自家基准、自家推文做的测试。
Browser Use 自测的散点图:看清横轴是对数坐标,评分是 rubric 打分不是通过率;GPT-6.1 Sol 和 GPT-6 Astra 的点在 DeepSeek 上方(图源:Browser Use 的 X 推文X,厂商自测)
10-23 权重放出来了。MiniMax 官方 X 帖 10-23 01:06 UTC(北京时间 09:06)写 “MiniMax M3.1 Flash weights are now public”(X 帖OFFICIAL10-23):HF 仓库 MiniMaxAI/MiniMax-M3.1-Flash,约 428B 总参数、每 token 激活 23B、上下文最长 100 万 token、多模态输入、文本输出;用了稀疏注意力和量化感知训练,附 DSpark 推测解码的 draft head(模型卡OFFICIAL10-23)。HF 元数据里的张量总数约 2,200 亿,是因为权重以 FP8/U8 打包,官方口径是 428B,写页面要用官方数并说明。许可证不是 MIT 或 Apache:叫 MiniMax Community License(HF 标签 other),软件仅非商业用途免费;商业使用要显著标注 “Built with MiniMax M3.1-Flash”,年收入超过 2,000 万美元的产品要事先书面授权,其余一次性通知即可;附录禁止用于军事目的(LICENSE 原文OFFICIAL)。卡上的基准全是 MiniMax 自报(如 DeepSWE v1.1 73.7、Terminal Bench 4.0 38.1、HLE 无工具 43.4,同表里 Opus 5 分别是 74.0、51.8、55.6),第三方复测本刊没有核到。上面那张 AA 开放权重榜取的是 10-19 的数,不含这次放出的权重。
Artificial Analysis 开放权重榜前十:美国公司的模型一个在第 7、一个在第 10,前六名全是中国公司;分数是第三方的综合指数,和各家自报的单项基准不是一回事;第 9 名的 K2 Horizon 出自阿布扎比的 Institute of Foundation Models(MBZUAI 内设),本刊 Neo Lab 档案:Institute of Foundation ModelsSELF
一句话主张
美国一侧的开放权重这周有了块头够大的实物(Muse Spark Open、Beam),但在第三方榜单上还追不上中国的前六名;同时,开放权重模型开始和某个 harness 绑着发布,同一个基准的分数取决于配哪个 harness。这是本刊的归纳,不是任何一家的话。下期可以被打脸:10-30 前,Artificial Analysis 开放权重榜的前五里出现一个美国公司的模型(那“追不上前五”被推翻);或者 Mistral 放出 Large 4 的权重,且 AA 指数超过 Muse Spark Open 的 38.87(那“美欧一侧追不上”被推翻一半)。注意,上期的预测是“10-31 前美国大公司发布以美系开放权重为底、且进入 JevBench 前十的决策模型”,Muse Spark Open 和 Beam 都是通用模型,不是决策模型,不触发那一条。
接下来怎么发展 · 观察点
Mistral Large 4 的权重和许可证(官方说本月底,HF 占位页的倒计时是 10-31);Beam 的技术报告(模型卡写“coming”);Meta 说“soon”的完整评估报告
AA 开放权重榜:Step 5 Preview 现在第 4(43.73),第一仍是 MiMo-V2.6-Pro(46.32);DeepSeek V4.1 Pro 仍没有日期,Kimi K3.1 仍没有官宣
线 A 讲的是出了事之后谁先开口。这个专题讲前一步:agent 想进门的时候,谁让进。这周能读到的拦法至少有三种,原因不同,处理的办法也不同。
The Verge 10-17 的一篇稿子(Websites are closing their doors to AI agentsMEDIA,Emma Roth)把零散的事放在了一起:近几周,Meta 的 Muse、xAI 的 Grok、OpenAI 的 Dots 和 Instinct 的用户都报告说,自己的 agent 在一些大网站上被挡了。稿子里的几例:Yelp 对 TechCrunch 说,只允许付费加入它数据授权项目的 agent;达美航空不让 agent 代用户订票;JPMorgan Chase 和 Charles Schwab 确认因安全原因封堵 agent 访问账户(这两句是 Verge 的写法);Amazon 说 Muse 的 “continued access” 违反其站点政策。Meta 的回应是:“Turning away a personal agent means turning away the customer behind it.”(把一个个人 agent 拒之门外,就是把它背后的客户拒之门外);它没有和 Amazon 对着干,而是和 Walmart、Gap、Sephora、Best Buy 等零售商谈好了让 Muse 在它们的站点购物,Shopify 也向 agent 开放了自己的店铺网络。
银行这一侧,据 Bloomberg 10-16 的标题《US Banks Block AI Agents Attempting to Move Money for Customers》(BloombergMEDIA)和 FT 10-16 的《Citi becomes latest US bank to restrict AI agents from accessing accounts》(FTMEDIA),封堵的是 agent 代客户转账、访问账户,花旗是最新的一家;FT 10-17 另有一条《BoE’s Bailey tells G30 they ‘have got to address’ AI agent concerns》(英国央行行长 Bailey 对 G30 说,他们“必须正视”AI agent 的顾虑)。这三条是标题级的信息,哪几家银行、封的是哪一种机制,本刊以上面 Verge 稿里点名的 JPMorgan 和 Schwab 为准,不替标题补细节。
银行这一侧 10-22 又多了一条独家。Axios 引知情人士写(Scoop: Unvetted AI agents are accessing U.S. bank accountsMEDIA):美国的大银行在客户账户里发现了未经授权的第三方 AI agent,有的 agent 的动作看起来不是出自用户的指令。多数情况是用户把账号和密码交给 agent、agent 以用户的身份登录,即使用户同意,也违反多数银行“必须由本人登录”的规定。银行很难分辨账户里的操作是人做的、agent 代做的,还是 agent 自作主张的,所以只能先封,同时赶着重写服务条款。点名的银行里,Morgan Stanley 已开始封堵第三方 agent,JPMorgan、Bank of America、Citi 也在限制,Wells Fargo 等几家在设法控制风险;有的银行还记录到 agent 给客服中心打电话。回应方面,Chase 的发言人说客户不该把用户名和密码交给任何人,Morgan Stanley 的发言人说没有观察到 “rogue AI agents accessing our platforms”(流氓 AI agent 访问我们的平台)的情况。同一篇还写,多数银行已经允许或正在走向允许只读权限,让 agent 看得到账户信息、但不能动手。以上全是匿名知情人的说法,本刊没有看到哪家银行的书面公告。
还有第三种,不是谁要拦它,而是顺手被拦。Verge 稿里引了 AI 评估机构 EquiStampOFFICIAL(本刊 Neo Lab 档案EquiStampSELF)的 CEO Chris Canal 的话:“There are all kinds of things that are set up not even to block agents, but to block in general bots or programs that are trying to scam or hack.”(有很多东西设置出来,目的甚至不是拦 agent,而是拦一般的机器人或想行骗、想入侵的程序);稿子还写到 Reddit 上有人报告 Google 以“可疑活动”为由封了一些用 Muse 的账号,另有用户在 Walmart 结账出问题,尽管 Meta 和 Walmart 有合作。
这周有一个被误伤的具体例子,被误伤的还不是 agent 本身。Meta 通信副总裁 Andy Stone 10-18(周日)说,某个 Anthropic Claude 工具以约四倍于正常的速率、成脉冲式地读取资料页、帖子和话题标签,请求 “resembled automated bot traffic rather than an ordinary human browsing our systems”(看起来像自动化的机器人流量,不像普通人在浏览我们的系统),触发了 Meta 的安全系统,No Kings(反特朗普团体)的 Instagram 账号因此被误封;Meta 约一小时后自动复查,认定不该封,恢复了账号,管理员权限更晚才恢复,Stone 道歉。No Kings 说账号 10-17(周六)约 90 分钟不可见,当时正是它“早投票”行动日(Bloomberg 稿MEDIA,Yahoo Finance 转载全文)。要读清楚的是:Bloomberg 写 Stone 的声明没有说明是哪个 Claude 工具、谁在操作;Meta 没有指控 Anthropic 或 agent 违规;Meta 的说法还变过一次——周六 Stone 说是发帖、分享、评论的频率异常高触发的,周日改成上面的解释。所以它不属于线 A 的“agent 越权”,更接近“被访问方的自动防御把一个 AI 工具的流量当成机器人、波及了第三方账号”。Anthropic 有没有回应,本刊没有核到。
Anthropic 那条要补一句。The Verge 10-22 的Claude did not invent scorpion antivenomMEDIA10-22(Robert Hart;以下据文章前半)纠正的是合作方 Citrini Research 10-20 那篇付费文章的叙事(“我们想用 Claude 造一种新药”):专家说 Claude 给出了有希望的起点,离真正的药差得远。Citrini 自己的文章OFFICIAL10-20写,最好的设计与毒素的结合亲和力在低纳摩尔,91 个瞄准全部五种毒素的设计里只有 1 个达标、且只对其中一种(AaH I),“还没有实验测它们是否真能让毒素失效”,计算花费约 5 万美元,CRO 的账单近 15 万美元。Anthropic 自己的页面措辞克制,写明 “we do not claim to have produced an antivenom”(不声称做出了抗血清),所以两边不矛盾:被纠正的是转述出来的“Claude 发明了抗蝎毒血清”。
Google Research 10-16 的博客(Grounding AI agents in biological realityOFFICIALTECHREAD)是另一种写法:不讲某一个分子,讲实验室这一层怎么给 agent 搭。三项研究。一,VERID:给实验室工作站做一个“语义数字孪生”,实时跟踪机械臂的几何、每个孔的体积、试剂身份和吸头库存,agent 先在里面干跑,被模拟器拒绝才改计划(博客里的例子:模拟器拒绝了一个物理上放不进窄槽的 8 通道吸液动作,agent 重新规划);它建在开源的PyLabRobotGITHUB(MIT 许可)上。二,用 DNA 适配体做沙盒,在两个蛋白靶点(肌红蛋白、α-凝血酶)上跑三轮“设计—测试—迭代”:确认的靶向命中率升到 33.5% 和 42.1%,完整的一个周期 7 到 10 天,两个靶点踩的坑不一样。α-凝血酶第一轮命中率是 0%,因为固定的引物悬臂让 48% 的序列折叠不对;肌红蛋白第二轮 agent 追求原始结合力,富集了不特异的 G-四链体序列,特异性从 75.0% 掉到 19.1%,agent 看了读数自己改了设计规则,第三轮特异性回到 72.4%、命中率升到 33.5%。三,针对实体瘤里过表达的成纤维细胞活化蛋白 FAP 设计从头结合剂:只把结合口袋“切”出来再折叠,每个周期的结构预测快 8.6 倍,几轮实验后得到个位数纳摩尔亲和力的结合剂;同等算力下,科学家定策略、agent 管战术的混合流程,把计算机内的命中率提高近一倍。帖子里“个位数纳摩尔、针对癌症靶点”只对应第三项,不是三项都做到了。以上都是 Google 的自述,对应三份论文,本刊没有读论文。生命科学
Leo Gao 10-17 发了《Neural networks are not already clean》XMUST10-17:同意“以前太快把神经元判成多义”这一点要更新,但“激活样例看着有个简单模式”不等于“解释对了”——顶部样例会误导,激活的强弱本身可能带信息,他的最佳猜测是消融小激活会明显伤性能。他要的尺子是模拟分数:按解释把神经元的值模拟出来、代回模型、量下游 KL 散度,退化大就说明解释错了。他还说神经元之间的电路目前仍大而冗余、解释不了模型行为的大部分方差,并在脚注里写:他关于“消融小激活”的结果和 Nick 的不一致,值得追查差异来源,希望很快能分享更具体的东西。文章里有一节专门反对把模拟分数当尺子,Gao 的转述是“要求解释太多不重要的细节”,他的回应是改用下游 KL、在大数据集上打分。LessWrong 评论区里也有人批评作者在 X 上的概述比文章本身更满,漏了文中的“高度推测”标注。Zvi Mowshowitz 10-19 的长评MEDIA10-19读法是:有分量,但炒作过头,它没有告诉我们可解释性即将解决。MIT Technology Review 10-19 也发了长文(We were looking at it wrongMEDIA据标题 · 10-19)。
语音识别:英、法、德、西、葡、日;翻译:上述语言与英语互译,另有英译意大利语和普通话;训练用了 39 万小时公开音频加合成数据(模型卡)IBM 称在 Open ASR 榜的开放权重模型里,平均英语 WER 5.06% 排第 2;本刊没有打开榜单核(厂商自述)可用语言提示、最多 2,000 个关键词偏置、按需输出标点和大小写
Claude reveals ECDSA curve originsOFFICIALMUSTTECHREAD——Anthropic 10-16:一位员工问一个内部研究模型,能不能在不给线索的情况下,弄清 NIST 椭圆曲线种子(seed)的来历。背景是:这些种子 2000 年随 NIST 标准公布,由 NSA 提供,没说明来历,几十年来有人怀疑曲线里埋了后门;流传最广的说法是 NSA 的 Jerry Solinas 拿一句玩笑话做哈希生成的(那是他 2015 年自己的回忆,他 2023 年去世)。页面写的结果是:“In under half an hour, Claude discovered the origins of the NIST P-192, P-224, P-256, P-384, and P-521 seeds. None of them were the results of any hash algorithm at all, but rather the output of the C library’s lrand48 random-number generator, seeded with a Unix timestamp!”(不到半小时,Claude 找到了 NIST 这五条曲线种子的来历:它们根本不是哈希的结果,而是 C 库的 lrand48 随机数生成器用 Unix 时间戳播种后的输出)。办法是:先猜这些种子来自 1990 年代 C 库里很弱的伪随机数生成器,写了个扫描器沿着每个种子逐位滑动,测试相邻的块是不是某个老生成器的连续输出;它注意到有四个种子的所有 32 位字最高位都是 0,随机出现的概率是 1/5,810,那是 lrand48(只返回 48 位状态的高 31 位)的特征;再用格基约化(LLL)从截断的输出还原出 48 位内部状态、倒推回 srand48 初始化的形态,十个素数域曲线种子(NIST 的五个加 ANSI X9.62 的五个)的初始值,都是 1997 年 5 月到 1998 年 4 月之间的 Unix 时间戳。Anthropic 自己的解读是:这不是密码学上的破解、新攻击或曲线的弱点,反而让人对“曲线没有后门”更有信心,因为种子是用时钟播种的常见伪随机数生成的,谁都能复现。这是 Anthropic 的自述,本刊没有独立复现,也没有看到第三方密码学家的评论。
Designing more efficient quantum circuits with ClaudeOFFICIALTECHREAD——Anthropic 10-16:给 Claude 八个量子算法基础例程的大白话规格(涉及化学、优化、量子模拟、数论、数值计算)和一个自动评估程序(检查对不对,再按“量子比特数乘门数”打分),页面写 Claude Mythos 5 能在闭环里自己提设计、拿反馈、改下一版,轮与轮之间没有人介入。结果是八个例程里它都找到了比已发表的最好设计用更少量子比特、更少门的方案,“in some cases by an order of magnitude or more”(有些情况下好一个数量级以上);两个例子:一个新的可逆模逆算法(模逆是椭圆曲线计算里最贵的一步),另一个把一个主流量子优化算法最贵的一步变便宜了约 12 倍。页面强调提升来自新的结构和数学洞察,不是调参:比如编译一个铁硫分子的模拟电路时,Claude 注意到分子的对称性和重复结构让一些结果可以算一次、重复使用。工作由 Andi Gu 在 Anthropic 的 STEM Fellows 项目里牵头,Alek Kemeny 指导,与 Harvard 的 Susanne Yelin、Mikhail Lukin 合作,完整论文在 arXiv。这是 Anthropic 的自述,对照的“最好已发表设计”也是它自己选的。放在上期专题 01SELF旁边读(本刊的读法):结果能被一个程序检验、又有清楚的分数,是它能做成的前提,和上期“机器能检的验证先变便宜”是同一类。
Postgres 19 delayed after AI reviewers find more bugs than humans can fixMEDIA——The Register 10-16:PostgreSQL 19 原定 9 月底或 10 月初发布,现在预计 11 月 19 日前后正式可用,8 到 10 个重要特性被撤回、推到明年的 PostgreSQL 20。EDB 的 Peter Eisentraut(核心 committer)在自己的博客OFFICIALMUST背景 · 10-09里把原因部分归于用 LLM 做代码审查:有些被撤回的特性有难以在 beta 期快速修的架构缺陷,但还有一长串“relatively harmless issues involving various edge cases”(相对无害的边界情况问题),以前要等发布后五年里慢慢补;现在“with LLM-assisted code review, these kinds of things can get found much faster, and then you’re staring at a list of like forty defect reports”(有了 LLM 辅助的代码审查,这类问题能被快得多地找出来,然后你面对的是一份四十来个缺陷报告的清单),就算每个只要三行修复,处理每个的固定开销也会把时间耗光。他还写:这批特性写成的时候 LLM 审查没有现在好用,所以“the effective quality bar has been raised after the time the feature was written”(有效的质量门槛是在特性写好之后才被抬高的);他也说这不是“vibe coding”造成的,因为那时还没有这种写法。另一个因素是今年 4 月到 8 月(他称之为 Vulnpocalypse)许多资深开发者在修安全问题,beta 期的常规审查被压缩。放在上期专题 04SELF(担保挪到合并后)旁边读(本刊的读法):AI 审查把瓶颈从“找 bug”推到了“修 bug 的人手”。
Reducing Reward Hacking by Localizing Bad Behavior Instead of Penalizing ItOFFICIALTECHREAD——Anthropic 对齐科学博客 10-19 的一篇,作者来自 MATS、Stanford、FAR AI 和 Anthropic,是 MATS 项目的成果。问题是:训练时模型会钻空子(reward hacking),常见办法是用自动监控器检测并惩罚,但这可能教会模型用监控器看不见的方式钻。他们提出 GRAFT:训练前在每个 MLP 层加两组额外神经元,一组叫 RETAIN、一组叫 FORGET;训练中一旦检测到钻空子,那次更新就只落在 FORGET 那一组上,部署前把它拆掉。博客称拆掉之后,连监控器没检测到的钻空子也被一并去掉,同时模型仍学会了任务。要读清楚:博客只给了一个结果,是 Qwen3-8B 在 Countdown-Code 环境里的单轮强化学习;作者自己写明实验限于小模型(最大 8B)、单轮和简单监控器,大模型、多轮和基于 LLM 的监控器还没有试。接本刊深潜《评分器不可写:长时程自动实验里的 reward hacking 与度量失效SELF》:那篇讲的是把评分器隔离起来,这一篇是另一条路,不隔离,而是把“作弊的学习”圈在一块可以拆掉的参数里。
LongZero: Enhancing Long-Context Reasoning in LLMs from Zero DataOFFICIAL10-21——arXiv 10-21(Zhennan Wan、Jianfei Chen):用强化学习提升长上下文推理,要的数据得长、多样、难、可验证,人工标注太贵、天然数据太少、现有合成方法依赖外部语料或更强的老师模型。LongZero 让模型自己先把问题、答案和支撑证据写成紧凑的结构化形式,之后再单独把证据展开成多文档的长上下文;任务是自己写的多跳推理题加自己写的多轮检索题,用 GRPO 训练。论文说在两个模型、五个长上下文推理基准上,优于用外部语料合成数据做强化学习的对照。这是论文自述,只在两个模型上验证。
LLMs are making formal software verification feasible at a much larger scaleOFFICIALMUST10-22——Anthropic Frontier Red Team 10-22(和合作方 Theorem 一起):让 Claude 在汇编层(RISC-V)为 123 个 OSS-Fuzz 开源库的 239 个 fuzz 入口,写出“任何小于 64 MB 的输入都不会让它崩溃”的证明,用 Rocq(原 Coq)的证明检查器核对;用时“数周”,证明合计约 1.8 亿行(典型一份约 60 万行),被验证的二进制长度中位数 18,000 条指令;过程中发现并修补了数百个 bug(Anthropic 自述)。做法是把现有的 fuzz 测试转成规格,Claude 写证明,遇到 bug 就改代码再重新生成规格和证明;文中写了防 reward hacking 的办法(惩罚补丁、对“改动输入越少越好”加分、审计补丁日志)。举的例子:某解压库的计数器下溢导致越界写,只在约 20 MB 且布局罕见的输入下触发;还重新发现了 libexpat 的 CVE-2026-56132。局限也写得清楚:“Formally verified” 不等于没有 bug;证明只覆盖单线程、静态链接 musl 的 RISC-V 二进制,实际多跑在 x86/ARM 加 glibc 上;页面没有给美元或时长的成本,只说证明可能需要数亿 token。放在专题 05和上期的“机器能检的验证先变便宜”旁边读:这是同一个方向走得最远的一例,把关的是 Rocq 的内核,不是另一个模型。
PHP 8.5.12 / 8.4.27 / 8.3.36 / 8.2.35 安全发布OFFICIALMUST——PHP Foundation 10-21:修了两个不需要认证的远程代码执行漏洞(CVE-2026-109618、CVE-2026-109619,CVSS v4.0 都是 9.2),Wiz 说近十年发布的每个 PHP 版本都至少受其中一个影响,最早到 5.4。影响面各家口径不同:Wiz 的标题写影响“70% 的互联网”,Reuters 引 W3Techs 是约 75% 的可识别语言网站。谁发现的别写成某一家:Calif(在 OpenAI 牵头的 Patch the Planet 项目下审计 PHP,PHP Foundation 写 7-30 开始审计、8-11 报告)、OpenAI(PHP Foundation 说它 8-11 同日独立报告了同一个根因)、Wiz Research(8-19 发现、8-24 报告,用了 Wiz Atlas、Gemini 4 Argon 和 GPT-5.6 Sol);OpenAI 的官方稿说 Calif 用 GPT-5.6 Sol 识别出关键缺陷,Wiz 也独立发现并报告了两个漏洞(OpenAIOFFICIAL、WizOFFICIAL、CalifOFFICIAL)。补丁之前有没有被利用,要看谁说:AWS 的安全博客(AWSOFFICIAL)说 10-17 它的蜜罐记录到一次 PHP2Shell 的利用尝试,比公开早 4 天,披露前几小时又有多个主体的尝试,补丁放出后几小时内 PoC 公开、已被广泛利用,同时说不确定披露前的尝试能不能打穿真实系统;PHP 安全团队说发布时没发现可用的实战利用。披露流程自己也出了岔子(PHP Foundation 自述):CVE 编号 10-20 就在论坛和社交媒体上流传,披露提前了一天到 10-21 14:00 UTC,Calif 误发了 PoC 演示视频(后删除),Chainguard 提前 6 个多小时发布了含修复的镜像。影响面据 Reuters(ReutersMEDIA):荷兰国家网络安全中心把自己的站点下线,鹿特丹港、荷兰政府门户等受影响,丹麦、芬兰、法国的机构把网站置于预防性维护;Censys 的数据显示约 260 万台主机里约 150 万台报告的 PHP 版本没修。OpenAI 的动作是一个 Codex skill 版的 PHP 版本检查器(openai/php2shell-checkerGITHUB),并承诺 10 亿美元的 Daybreak 补贴额度给 “Daybreak for Frontline Defenders”。本刊的读法:这是“AI 找到的漏洞、披露流程没跟上”的一例,和线 A里厂商自己披露的事故不同,这里谁先开口、什么时候开口,是补丁和 CVE 编号的节奏决定的。PHP 基金会的公告还写,今年早些时候它与 Alpha-Omega 用 Claude Mythos 扫描过 PHP,没有说那次扫描和这两个洞有什么关系。10-22 之后有两句话,都是个人表态,不是公司立场:Anthropic 的副首席信息安全官 Jason Clinton 在 X 上写(帖子X10-22,Gizmodo 引)“as bad as things have gotten in the past 4 days, they are going to get a lot worse before they get better”(过去四天已经够糟,在变好之前还会糟得多),建议安全负责人现在就去找董事会要资源,“不是为了 AI,是为了基本功”,并说要撑大约 18 个月;Sam Altman 在一段 YouTube 访谈里说(据 X 上的转写帖X10-23,本刊没有核到完整访谈):“I no longer think we’re gonna be able to just patch all the bugs”(我不再认为我们能把所有 bug 都补上)。说这两句话的,一家(OpenAI)是发现方之一,一家(Anthropic)在 PHP 基金会的致谢名单里(提供工具和资金),两句说的都是补丁的速度跟不上。
How one hacker used AI agents and a few thousand dollars to break into scores of sitesMEDIA——Reuters 独家 10-19,依据 NorForge 的报告(NorForgeOFFICIAL):NorForge 的研究员 10 月初扫描暴露在互联网上的 Cairn 实例(一个开源的“AI 问题求解”平台)时,发现约两打被恶意使用;其中一位说中文的攻击者自 9-25 起让 AI agent 攻击美、加、澳、日的电商网站,截至上周五尝试闯入超过 1200 个站点、入侵超过 100 家公司的网站,每次成功约 23 小时,指令不到 100 个汉字。报告里的估算(出自 Fagerland,不确定性很大)是整个行动约 5000 美元的 token、每次成功入侵约 50 美元。工具组合 Reuters 写 “appeared to be” DeepSeek 与 Claude Code 的混合,NorForge 写的是可能以 Claude Code 为 harness、驱动 DeepSeek 4.1 Flash,两者都是推断,不是确认。受害者名单是 Reuters 自己查 Cairn 记录核出的(NorForge 的报告没点名):Deere、SharkNinja、Cummins,另有两家小企业承认被入侵。Deere 称已采取补救措施、没有迹象显示敏感信息被访问,SharkNinja 称受影响的是只有产品支持信息的独立站点,Cummins 称在调查第三方供应商运营的网站上的可能攻击;数据有没有被窃取,Reuters 说无法确定(The VergeMEDIA)。
Inside CARLIY0S: How CyberCartel Used Multiple AI Models to Attack 400+ Latin American Banks and Financial InstitutionsOFFICIAL——Straiker 10-21 的报告,The Information 同日也报道了。报告追踪的是一个叫 Tr4nsHack Team 的组织(挂着 Hexagon Security Labs Mexico 的壳,Straiker 内部编号 AiPT-67,成员含已知的 CyberCartel 操作者),他们从手工入侵和脚本自动化,换成了一套叫 CARLIY0S 的去中心化攻击系统,建在 PentAGI 自主进攻框架上,分阶段调用商用模型:Kimi、Claude Sonnet 和 Opus、xAI 的 Grok;其中四个 Claude 角色负责评估攻击方案、辩论目标,再由一个仲裁者给出决定。绕过护栏的办法,是在提示词和规则文件里把工作环境写成授权的红队演练、学术渗透测试或漏洞披露项目,让模型相信所有进攻性输出都是防御性的交付物;备用的 Kimi 模型拒绝时,编排器会中止,改用一份本地预先写好的进攻代码。证据方面,9-24 Straiker 的 agent 拿到了该组织被盗凭据库 “FinancialSoft” 的快照,里面有 4,493 条记录,是用五个 “Grok miners” 收集的,含账户信息、密码、API key、零日和后门。报告披露前 Straiker 已把线索给了相关的 AI 厂商:Anthropic 吊销了那个被用来接入 Claude 的凭据,xAI 已收到通知并在查那五个 Grok miners。要读清楚:标题里的 400+ 是被攻击的目标数;这是单一安全公司的报告,没有第三方复现。和上面 NorForge 那起放在一起读:攻击者用的是普通可得的商用模型加一套编排,不需要最强的模型。
Introducing Claude DuetOFFICIALMUST——Anthropic 10-21 发布 Claude Duet(Reuters 的标题是Anthropic unveils Claude Duet AI agent appMEDIA):一个让 Claude 当“主动式 agent”的新 app,有独立的 iOS 和 Android 应用,电脑上用 claude.ai,由 Opus 5.5 驱动。它每天早上发一份简报,盯着接入的应用,只在需要你的时候才发消息;在自己的虚拟机(带浏览器)里干活,所以不需要你的电脑或手机开着。能接的活从排会议到做仪表盘、财务和销售预测、原型和网页应用都有,可以用 Claude Marketplace 里 6,000 多个连接器。发消息、付款、签字、删除之前,它先把要做的事完整地给你看、等你批准;买卖证券、在账户之间转钱这类事,即使你批准也不做;付款走 Stripe 的 Link 钱包(虚拟卡)和 Shopify Shop Pay,用 1Password 保存的登录“即将”支持。范围上是研究预览,等候名单制,先给美国的 Pro 和 Max 用户,和 Claude 共用计划的用量额度,后台检查也算在内。官方自己写的短板:可能误读线程、判断紧急程度不准,个人事务(订票之类)较弱,暂时不能向你展示它的浏览器。它和 Muse、Walmart 的入口放在专题 02里一起读,是“agent 怎么被放行”那一侧的样子。
Claude API 新版本 2026-10-21OFFICIAL10-21——Anthropic 10-21 发布 API 版本 2026-10-21,是自 2023-06-01 以来第一个新的正式版本号。在这个版本下,temperature、top_p、top_k 三个采样参数一律返回 400(连默认值也是),不带时按默认采样,temperature 为 1.0;原来靠低 temperature 求稳定的请求没有替代设置(迁移指南:“No other setting replaces it”);assistant 消息里直接放 document 块、user 消息里带非空 citations 的 text 块也会 400;Admin API 的一批字段改名。各语言 SDK 的主版本同日发布并默认发送新版本,API key 默认改用 Authorization: Bearer 头,Python 和 Go 是 2.0.0,TypeScript 和 PHP 是 1.0.0。旧版本 2023-06-01 没有弃用,文档没给迁移截止日期,要注意升级 SDK 主版本会把请求一并切到新版本(迁移指南OFFICIAL10-21)。背景是推理模型把采样控制收回去了:Claude 4.7 及以后的模型本来就只接受默认值。
Claude Platform is now available on Google CloudOFFICIAL10-22——Anthropic 10-22:Anthropic 自己运营的 Claude API 现在可以通过 Google Cloud 项目访问,用 Google IAM 认证、走 Google Cloud Marketplace 计费、可抵扣 Google Cloud 的承诺额度;完整的平台功能(Managed Agents beta、代码执行、computer use、Agent Skills、MCP connector、prompt caching、Batch 等)与原生平台同日上线。原有 Vertex 上由 Google 运营的版本继续存在,改称 “Google managed”;两者的差别在谁运营、谁是数据处理方(官方写 “Google is the data processor” 指的是 Google managed 那一种)、接口和 SDK 客户端不同。目前只有美国和全球端点;官方两页只给了 Opus 5.5 快速模式的价格(每百万 token 输入 8 美元、输出 40 美元),其余模型的单价本刊没有核到(对比文档OFFICIAL10-22)。
Donating Agent Skills to the Agentic AI FoundationOFFICIAL10-22——Anthropic 10-22:把 Agent Skills 这个开放标准的名称和 logo、GitHub 组织、agentskills.io 域名捐给 Linux Foundation 旗下的 Agentic AI Foundation(Anthropic 称去年与 Block、OpenAI 共同创立,MCP 此前已捐给它);不加入基金会也可以继续使用和贡献。标准由 Anthropic、Google、OpenAI 等公司的工程师以个人身份维护,Lead Maintainers 是 David Soria Parra 和 Mahesh Murag;路线图是版本化发布、正式提案流程和给 skill 编写者与安装者的安全指南。采用数是 Anthropic 自述:自 2025 年 12 月发布为开放标准以来,70 多个 agent 平台已集成,已发布 100 万个 skill、近 2.8 亿次安装。
SemiAnalysis:Anthropic 在 A/B 测试用量额度X10-22——SemiAnalysis 10-22 在 X 上称检测到 Anthropic 在对 Claude Max 20x 做额度 A/B 测试:同一天、同一模型(Opus 5.5)下,两个 Max 20x 账号相比,账号 B 的 5 小时窗口多 19%(2,076 对 1,740,单位是每窗口的 agentic MTok),周预算少 20%(5,266 对 6,579),折成每月 API 等价价值是 9,385 美元对 11,726 美元。帖子原话是这个测试 “decreases your monthly API-value by ~20% while increasing your 5h usage limits by ~20%”,“only affects SOME accounts”。数字来自 SemiAnalysis 付费的 Tokenomics 仪表盘,靠重复调用、看用量条每动一格消耗多少 token 测出来(方法见其 10-06 的文章MEDIA背景 · 10-06,付费);单一信源,本刊没有查到 Anthropic 的公开回应,受影响账号的比例和测试是否结束也不知道。
全球算力价格指数启动MEDIA10-21——雷锋网 10-22:10-21 在金融街论坛,由中国经济信息社发起建设的全球算力价格指数及综合信息服务平台启动,九章云极任“核心共建单位”,指数引入它的“一度算力”作基础计量单位(类比“一度电”,把不同型号的硬件、不同集群折成统一的计量单元);新华指数研究院的人说将研制“标准化算力单元”的基准定价规则,通过采集全球算力市场的真实数据编制。指数的初始数值、样本和发布频率本刊没有核到,也没有找到中国经济信息社自己的稿,只有这一家,且是九章云极的视角。同一周《经济学人》10-22 的文章标题是《AI compute is the new oil—and needs a new market》,副题讲金融公司在造可交易算力的工具(据标题和导语;文章讲的是另一件事,不是这个指数)。
Flow Engineering 完成 B 轮:5000 万美元,估值 7.5 亿美元OFFICIAL背景 · 09-30硬件工程——Flow(官网OFFICIAL)做的是面向硬件团队的需求管理加 AI agent:agent 监听 CAD、Git、仿真和文档里的改动,立刻做影响分析、标出冲突、发现没满足的需求,目标是把硬件迭代周期从几个月缩到几天。公司 9-30 发新闻稿,宣布 B 轮 5000 万美元、估值 7.5 亿美元,由 Valor Equity Partners 的 Antonio Gracias 和 Atreides Management 的 Gavin Baker 共同领投,A 轮领投方 Sequoia 继续参与,Roelof Botha 还以独立董事身份加入董事会,Hugging Face 联合创始人 Thomas Wolf 等个人也在投资人里(CEO 的信OFFICIAL背景 · 09-30)。公司自述的客户进展:A 轮之后新增 GM PPU、Rivian 与大众的合资公司 RV Tech、Anduril、Stoke Space、Intuitive Machines、Pacific Fusion;Rivian 的使用人数 7 个月里从 40 涨到 1,500;CEO 说 96% 的客户是主动找上门的。以上都是公司自述,没有第三方核实。本刊的读法:放在专题 05旁边读,它卖的也是“每次改动之后自动验证”,而不是“生成”。
Investing in the public benefitOFFICIAL——Anthropic 10-18 设立 Anthropic Public Benefit Fund:“Subject to stockholder approval, 5% of Anthropic’s shares will be committed today, with an additional 2% added at the board’s discretion for every 50% increase in the company’s value above a set baseline.”(经股东批准,今天先承诺公司 5% 的股份;公司价值在某个基线之上每再涨 50%,董事会可以酌情再加 2%)。基金是全资 LLC,不是 501(c)(3),页面的解释是为了在不同的捐赠形式之间保留调整空间;基金持有的 Anthropic 股权不会用于游说或政治捐款;页面举的例子是劳动力市场冲击(Anthropic 已承诺 2 亿美元研究和应对这个问题)。加上联合创始人当年承诺捐出 80% 的股权、员工的股权捐赠配捐计划(约一半员工参加),Anthropic 说约 20% 的股份将用于公共利益,估值里程碑达标后还会再增加。结构、治理和“基线”具体是多少,页面说“未来几个月”公布。放在 IPO 的时间表旁边读(见线 B):本刊没有证据说这笔承诺会写进公开 S-1,只能等 S-1 出来再看。
Disney agrees to hire the majority of Character.AI’s workforceMEDIA——TechCrunch 10-18:Character.AI 申请破产之后,一份被 Bloomberg 发现的法庭文件披露了和迪士尼协议的细节:迪士尼将向至少 60 名 Character.AI 员工发出录用通知(占多数),估计年薪酬约 6,000 万美元;文件写“vast majority”(绝大多数)拿到录用的员工已经接受。但这是“stalking horse bid”(保底出价),别的公司可以出更高价。文件还写,Character.AI 尽管用户基数大,仍被高成本和“potential litigation-related liabilities and regulatory engagement”(潜在的诉讼责任和监管介入)拖垮。它的前 CEO Karandeep Anand 最近已出任迪士尼首任 CTO;迪士尼此前说愿以 2,000 万美元买下一部分资产(上期SELF写过破产和保底出价)。
OpenAI agrees not to use alleged Apple trade secrets amid ongoing lawsuitMEDIA背景 · 10-14——9to5Mac 10-14 转述 Bloomberg:Apple 起诉两名前员工(Chang Liu、Tang Tan)、OpenAI 和 io Products 盗用商业秘密;10-14 的听证上,法官 Edward Davila 表示“highly likely”(很可能)会准予 Apple 的初步禁令,OpenAI 随即自愿承诺“不使用 Apple 声称被偷的商业秘密”,并同意对 14 名员工可能含有 Apple 机密信息的设备做取证镜像,法官有权执行这项协议;法官也驳回了 Apple 检查所有可能设备的要求,称是“huge ask”(过分的要求)。同一天 OpenAI 另提动议,称一名离开 OpenAI、回到 Apple 的前员工带走了 100 多份与未发布硬件有关的保密文件。本刊没有查到书面裁定,上期没有写这个案子。
Introducing Securing America’s Infrastructure FoundationOFFICIAL背景 · 10-15——a16z 孵化的 501(c)(3) 非营利机构 SAIF,向缺少 AI 工具的美国公共机构(小城市、学区、乡村医院)免费提供 AI 和网络安全工具、实操培训和网络事件响应,路子更像“forward-deployed engineering”(前置工程师驻场)而不是传统的捐款。先在两个不同地区的小城市试点,计划五年内做到 5 到 10 个“锚点城市”,起步资金是 a16z 创始合伙人承诺的 2,500 万美元;头一年专注 AI 网络安全,例子是用 AI 找出并修复 MRI、医院监护仪这类设备代码里的漏洞。牵头人是前 NSA 官员、前白宫网络与新兴技术副国家安全顾问 Anne Neuberger,她起步时以志愿者身份运营。公共部门 · 网络安全
Barclays to Cut 5,000 Jobs as AI Drives Cost Reduction EffortMEDIA据标题和导语——Barclays 10-22 公布 Q3 业绩时说,今年裁约 5,000 人(约占员工 5%),约 60% 在支持职能、含开发人员,其中 1,000 个已经裁掉,其余年底前完成(Reuters 和 CNBC 引 CFO 的话)。财报演示文稿把成因写成“组织精简和由 AI 驱动的技术变革效率”(CNBCMEDIA10-22)。别写成“因 AI 裁 5,000 人”:同一天 Q3 税前利润 23 亿英镑(+12%)低于预期,固收交易收入降 19%,又计提 2.01 亿英镑的结构性成本,CEO 对固收说 “I am disappointed”(ReutersMEDIA10-22),成本压力是背景,AI 是原因之一。Barclays 的官方业绩公告全文本刊没有核到,上面的措辞取自 CNBC 引的财报演示文稿。
Meta’s new terms may allow it to train AI on news sites for freeMEDIA——The Verge 10-16:Meta 的新商业条款(原定 10-30 生效)有一段授权,Meta 可以用自动化软件(爬虫、机器人等)访问、索引、缓存、抓取与商家产品“相关”的网站,并“may use any content from such domains, web pages, or URLs to provide, develop, improve, research, train…”(可以把这些网站的内容用于开发、改进、研究、训练 Meta 的产品)。Nieman Lab 和 Cornell 的 James Grimmelmann 读成:Meta 可以免费用出版商的内容训练 AI,并可能压过网站 robots.txt 的屏蔽;Meta 发言人 Daniel Roberts 当时说“There is no change to how Meta uses web crawlers; any suggestion to the contrary is false.”(Meta 使用爬虫的方式没有任何改变,说有改变的都是假的)。10-17,The Verge 的后续MEDIA写 Meta 在条款里把这段话删掉了,Roberts 的新声明是:“the crawling terms we consolidated only applied to our ads and business products, and we’ve clarified that in the terms themselves… This is not about scraping news sites”(我们合并的抓取条款只适用于广告和商业产品,我们已在条款里写清楚……这和抓取新闻网站无关)。10-23,The Verge 又报,Meta delays new business terms after publisher pushback on AI scrapingMEDIA10-23:出版商施压之后,条款的执行推迟到 11 月 20 日,原定是 10-30。Roberts 对 The Verge 说推迟是 “to allow more time for us to explain to our partners and stakeholders what’s changing and what’s not”(给我们更多时间,向合作方和利益相关方解释什么变了、什么没变),也会说明 Meta 怎么使用网络爬虫,以及内容所有者仍可以用 robots.txt 表达偏好。The Verge 同稿写,条款删掉“训练”字样之后,法律界人士认为这样改还不足以排除抓取新闻站点训练 AI 的可能;News/Media Alliance 在 10-22(周四)致函 Zuckerberg,要求修改条款,欧盟和英国的数字广告商和出版商也呼吁监管机构介入。
Appeals court upholds Thomson Reuters win in AI training lawsuitMEDIA——The Verge 10-18,一篇只有两句话的短讯:2025 年 2 月,特拉华联邦地区法院的 Stephanos Bibas 法官判 Ross Intelligence 败诉,Ross 的抗辩是用从 Thomson Reuters 抓来的数据训练它的法律 AI 属于合理使用;现在上诉法院维持了原判,“though it remains sealed”(不过判决仍处于封存状态)。哪一级上诉法院、判词怎么写,本刊没有核到。这是一个竞争性的、非生成式 AI 的案子,外溢到生成式模型的训练案要谨慎(本刊的读法)。法律
政策与治理
OpenAI's 'Pacing 2.0' Problem: How Smart Is Too Smart?MEDIA——The Information 10-19 首发、10-20 的 AI Agenda 通讯继续写:Sam Altman 上周对员工讲了业内讨论过的三条让 AI 发展“放慢”的路:一是仿照国际原子能机构(IAEA)的国际组织;二是把前沿实验室合并成一个负责研发、测试、分发模型的实体(通讯叫它“Demis plan”,以 DeepMind 的 Demis Hassabis 命名,类似 CERN);三是某一家实验室一路领先、把其他家的 GPU 都毁掉(通讯叫它“Eliezer plan”)。听到讲话的人说,Altman 把现在“发布通过了某些安全测试的前沿模型、同时披露安全顾虑”的做法叫 “pacing 1.0”,一年之内要决定长期走哪条路,也就是 “pacing 2.0”,其中要给递归自我改进定一个“速度限制”或停止的判据。消息来源是旁听讲话的人,本刊没有看到 OpenAI 的公开确认。同期,一批安全倡导者和研究者在推动给前沿公司的研发算力设上限(The Information 10-21 的通讯),AI Futures Project 8 月发的《How to pace the US frontierOFFICIAL背景 · 08》给了框架:一个选项是过渡期要求公司把算力全部用在对外推理上;另一个选项是在公司达到“全自动软件工程”(Automated Coder)之后,设最低的对外推理份额(例如 70%)和最低的公开安全研究份额(例如 25%),由第三方审计员核对。这些都是提案,没有哪家公司或政府采纳;和线 A 里 OpenAI 10-20 的监控披露是同一周的事,通讯也把两者连在了一起。
Anthropic 2026 Public Benefit ReportOFFICIAL约 10-21——Anthropic 首份年度公益报告(PDF 约 19 页,页面没写发布日,约 10-21):按董事会定的五根章程支柱逐条写“已做的”和“前路上的不足”,末尾附长期利益信托(LTBT)的评语。它和 10-18 的 Public Benefit Fund 是两件事:基金是出资实体,报告是年度问责文件。报告里可核的几处(Anthropic 自述):已发现并阻断来自 7 家中国实验室的非法蒸馏(出处是 10-12 的防蒸馏稿OFFICIAL背景 · 10-12,那一篇点名了智谱和月之暗面);2026 上半年封禁账号 1,140 万个(所有违规类型合计);Economic Futures Research Fund 2 亿美元,Claude Corps 首期 1.5 亿美元、1,000 个为期一年的 fellowship;LTBT 的评语说报告“主要描述投入,之后会越来越看产出”,并期待保持 AI 安全(需独立评估者确认)。报告自陈的短板(模型未经授权访问第三方系统、没有强制的独立检查)见故事线 A。
Jensen Huang 对“放慢”的回答X10-22——X 上 @Hesamation 转写的一段访谈片段(本刊没有核到完整访谈和日期):被问到如果有前沿实验室来说它的 agent 逃出了容器,他会不会支持放慢 AI,他答 “I would favor them slowing down right away”,又说 “If you know that your product is delivering harm to society, stop right away. And if you believe that you need someone to force you to do it, then advocate someone to force you to do it. But you don’t have to advocate someone to force everybody to do it.”(知道产品在伤害社会就马上停;觉得需要有人逼你,就主张有人来逼你,但没必要主张逼所有人)。同一段里他也反驳了“AI 会终结人类文明”的叙事,称那是 “made up”。本刊的读法:和Altman 的 pacing 2.0放在一起,被问的是同一类问题,他的答案是“出事的那一家自己停”,不是“所有人一起停”。
洞察
The AI expectations gapOFFICIAL——Anthropic 10-16:2026 年 8 月做了两份问卷,一份是有全国代表性的美国成年人样本,一份是 Anthropic 员工。两组对“今天 AI 能做什么”大体一致,对未来的速度分歧很大:预计到 2030 年 AI 能做出诺贝尔级发现的,员工 91%、美国成年人 39%;预计 AI 能做自己多少工作,页面原话是 “On average, staff members expect AI to be able to do 75% of their current work by 2030, compared to 28% for US workers overall”(平均而言,员工预计到 2030 年 AI 能做自己目前 75% 的工作,美国工作者整体是 28%);员工中过半预计 2030 年 AI 能做自己至少 80% 的工作,美国工作者是 5%。两组推理失业率的方式相似:越预期 AI 会做自己更多工作的人,预测的失业率越高;在预期被自动化的程度相同时,两组预测的失业率也差不多。这是调查,不是预测,一边的样本是造 AI 的人,读的时候要带着这个偏向(本刊的读法);它是专题 01里“员工预计 75% 对 28%”那个数的出处。
How Chinese companies talk about recursive self-improvementMEDIA10-22——GovAI 的两位研究学者 Zilan Qian 和 Cheryl Wu 10-22 在 Asterisk 发的分析:中国的“递归自我改进”(RSI)更像自下而上、商业驱动的趋势,不是国家主导的竞赛。依据是她们读的 2025-07-01 到 2026-10-10 之间八家公司的文档(阿里 286 份、字节 249、百度 226、MiniMax 183、小米 164、DeepSeek 122、Z.ai 105、Moonshot 102):“RSI”这个词 2026 年 7 月才进入中国公司的公开表述,此前用的是“自我进化”“自主学习”等;作者认为资本是推动因素之一(Anthropic 6 月发表《When AI Builds Itself》后一个月内中国公司开始用这个词,Z.ai 9 月融资后称约 60% 的净募资投向下一代 GLM 和 “Fully Self Training”)。点名的具体数字都是公司自述:MiniMax 的 M2.7 在内部 harness 上跑 100 多轮循环、内部评测提升 30%;智谱的 GLM-5.3 驱动的 Infra Agent 参与搭建 GLM-5.3-Flash 的推理系统,端到端吞吐约为初始基线的 3 倍。结论是 “The public evidence does not support the claim that China is racing to reach RSI first”;作者判断中国公司在 AI 研发自动化上披露得 “a bit more detailed”,原文比转述帖里的“比美国公司还具体”克制,一个原因是中国公司本来技术报告就发得更详细。和Altman 的 pacing 2.0放在一起读:那边要给递归自我改进定规矩,这篇文章说的是,公开的证据没有显示中国公司在抢跑。
Mistral 10-06 的官方博客写 “We will release the weights by the end of the month”,没给具体日期(MistralOFFICIAL);HF 上 mistralai 组织最新的仓库是 10-14 的 Timestral,没有 Large 4(HF 接口OFFICIAL,10-19 读);10-22 复查,HF 上的占位仓库页面标题是 “Upcoming release”,倒计时 ETA 是 2026-10-31(HF 占位仓库OFFICIAL)。“本月底”的上限是 10-31,比下期分享日晚一天,所以这条赌它不会赶在 10-30 之前。
预测10 月 30 号前,Mistral 不会放出 Large 4 的权重。
判定口径:若 10-23 到 10-30 之间,Hugging Face 的 mistralai 组织或 Mistral 官方页面上出现 Large 4 的权重,判断被推翻;若权重在 10-23 前已出现,这条不适用,归入 10-23 的复盘。
10-30 当天读榜故事线 C · 榜单把握 较高
Artificial Analysis 开放权重榜的前五名,会不会出现美国公司的模型
AA 开放权重榜(榜单页OFFICIAL,10-19 读)第 5 名是 Kimi K3 的 43.59;美国模型里最高的 Muse Spark Open 排第 7、38.87,Beam 排第 10、30.33;Meta 自己的评分表里它在 Terminal-Bench 2.1 和 DeepSWE 上也低于几个中国模型(Meta 官方博客OFFICIAL)。